应用笔记:Shared Memory#
在 imaFlex 和 marathon 采集卡上使用 Shared Memory#
在采集卡上,使用 Memory 的每个运算符通常仅分配给一个物理内存。但在 imaFlex 和 microEnable 5 marathon 采集卡上,其概念有所不同。在这些采集卡上,您可以使用速度快得多的 DDR4(在 imaFlex 上)或 DDR3(在 marathon 上)内存。但是,这只是一个单一的物理内存,因此所有使用 Memory 的 VisualApplets 运算符将共享带宽。
采集卡的内存配置最好通过 VisualApplets Device Resources Documentation 来确定。在此文档中,您可以找到与在 VisualApplets 设计中使用 DRAM 元素相关的信息:RAM 大小、RAM 数据宽度以及每个 RAM 的带宽(除 marathon 系列外的所有平台)以及 marathon 系列的总 RAM 带宽(共享)。
信息
VisualApplets Device Resources Documentation 中给出的带宽值是理论最大值。在实际使用中,效率可能会降低。
本文档指导您利用 RAM 大小和 RAM 数据宽度的信息,针对特定平台高效使用 Memory。它还可帮助您计算 marathon 系列每个 RAM 的对应带宽。
高效使用 DRAM#
在 VisualApplets Device Resources Documentation 中,您可以找到有关特定平台的 RAM 大小的信息:
- 对于 imaFlex CXP-12 Quad:3 x 512 MiB DDR4
- 对于imaFlex CXP-12 Penta 5 x 512 MiB DDR4
- 对于marathon 系列和 Lightbridge:4 x 512 MiB DDR3
这些值提供了有关总内存大小的信息(例如,对于marathon 系列:4 x 512 MiB = 2 GiB (2^31 字节)),以及哪个分区VisualApplets 操作员最多可以使用(对于marathon 系列:512 MiB)。
只有使用完整的 RAM 数据宽度信息(另请参见 VisualApplets Device Resources Documentation),才能为每个算子高效地使用此最大 RAM 大小:
- 对于 imaFlex CXP-12 Quad,RAM 数据宽度为 384 位。
- 对于imaFlex CXP-12 Penta RAM 数据宽度为 640 位
- 对于marathon VCX-QP VF2 的 RAM 数据宽度为 512 位
- 对于marathon VCL、VCLx 和 Lightbridge 的 RAM 数据宽度为 256 位。
RAM 数据宽度是位宽度乘以并行度和与 DRAM 操作符连接的链路的内核元素。 VisualApplets 设计。
DRAM 的使用示例#
这个例子使用了一个简单的VisualApplets 设计marathon VCL平台如下图所示。
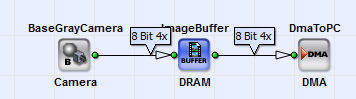
该示例使用的 Parallelism 为 4,Bit Width 为 8 bit。因此,该示例仅使用了 4 x 8 = 32 bit 的 RAM 数据宽度。但是,为了达到最高效率,带宽需要达到 256 bit。因此,您必须将 Parallelism 增加到 32,如下图所示。
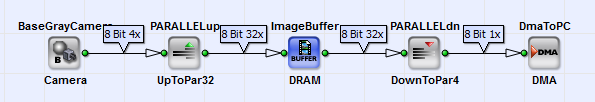
现在,此设计可确保您能高效使用 DRAM。通常,最好始终充分利用可用的 RAM 数据宽度。然而,有时这并不可行,因为您需要更多的资源、您的数据格式无法被 256 整除,或者算子的参数不再允许使用完整范围。因此,您需要了解是否也可以使用较低的 Parallelism。为此,您需要了解内存带宽,这将在下一节中进行解释。
Memory Bandwidth#
您可以在 VisualApplets Device Resources Documentation 中找到有关单个 DRAM 元素最大 Memory Bandwidth 的平台特定信息。由于您需要考虑从 RAM 读取和写入,因此在计算结果带宽时,最大带宽需除以 2:
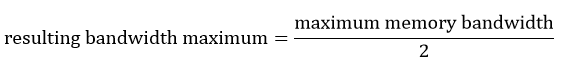
只有在使用完整的 RAM 数据宽度时,才能达到此结果带宽值(请参阅高效使用 DRAM 一节)。因此,您需要在计算结果带宽时考虑比率 使用的 RAM 数据宽度 / 完整的 RAM 数据宽度:
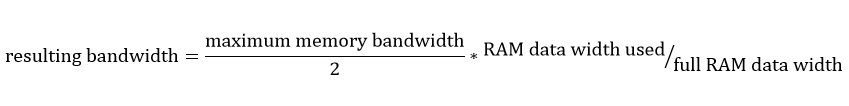
根据此公式,您可以计算出所需的 RAM 数据宽度:
bit width * parallelism * kernel elements of a link connected to a RAM element 在设计中使用该宽度可实现特定的最终带宽。这意味着,如果您已定义 Bit Width 和内核元素,还可以计算出连接到 RAM 元素的链路的最低所需 Parallelism。
Memory Bandwidth 计算示例#
您可以计算Memory Bandwidth 一节中设计示例的结果带宽。对于图 1 中所示的 RAM 数据宽度为 32 bit 的设计示例,其结果带宽为:
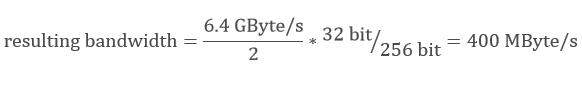
对于图 2 中所示的 RAM 数据宽度为 256 bit 的设计示例,其最终带宽为:
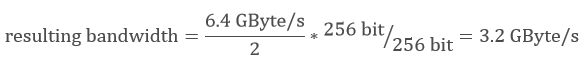
Shared Memory#
Memory Bandwidth 一节中的带宽计算公式适用于所有仅存在单个 DRAM 算子的采集卡平台。它也适用于除 marathon 系列外所有平台上小应用程序中每个 DRAM 元素的带宽计算。如果您使用多个算子,则 marathon 系列的总 Memory Bandwidth 将被共享。然后,单个 DRAM 算子的结果带宽计算公式如下:
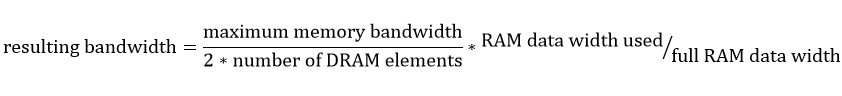
Shared Memory 示例#
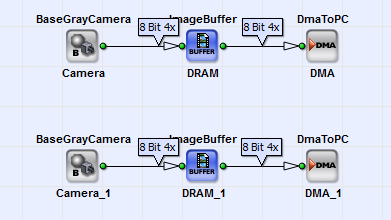
以下针对 marathon VCL 平台的示例展示了两个相机、两个 DRAM 元素(RAM 数据宽度为 32 bit)和两个 DMA,如下图所示:
最终带宽为:
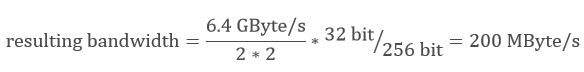
与 Memory Bandwidth 一节中计算的、RAM 数据宽度为 32 bit 但设计中只有一个 DRAM 算子的结果带宽相比,具有两个 DRAM 算子的结果带宽是之前值的一半。为了使具有两个 DRAM 算子的带宽与具有一个 DRAM 算子的带宽相同,您需要将 RAM 数据宽度加倍(= 64 bit)。
算子配置#
算子配置会自动适应给定采集卡硬件可用的 RAM 数据宽度。因此,大多数算子都允许使用 VisualApplets Device Resources Documentation 中给出的 RAM 数据宽度。某些算子仅允许 Parallelism 为 1。为了克服 64 bit 的链路 Bit Width 限制,其中一些算子接受 kernel 以使用高效的 RAM 数据宽度,正如高效使用 DRAM 和 Memory Bandwidth 一节中所解释的那样。有些 DRAM 算子属于例外情况,需要进行特殊配置才能实现高效使用。有关算子最佳配置的详细信息,请参见 operator CoefficientBuffer documentation。