延迟#
关键术语
延迟 是指单个像素从相机(或其他源)输入穿过生成的 FPGA 流水线到输出端(例如 DmaToPC)所需的时间。该延迟发生在采集卡上,而不是 VisualApplets 编辑器中。 带宽 是指每秒可以流经链路的像素数量。
设计可以同时具有高带宽和低延迟:许多像素在 FPGA 流水线中并行移动,但一帧中的第一个像素在交由 DMA 之前仍然需要一些时间。
延迟与带宽#
Bandwidth 和 latency 描述了同一流水线的不同 Property:
| 带宽 | 延迟 | |
|---|---|---|
| 问题 | 每秒传输多少数据? | 单个像素在处理前等待多长时间? |
| 取决于 | Parallelism 和基础设计时钟 | 运算符类型和算法 |
| 公式(链路) | 带宽 = Parallelism × Base Design Clock | 按运算符定义;见下文 |
流水线可以同时传输和处理图像数据。例如,当第 1000 个像素已经在输出端时,第 5000 个像素可能仍处于相机输入端。整体数据速率(带宽)保持较高,因为多个像素在设计中并行运行。延迟仅描述单个像素的延迟。
设计指南
在从 VisualApplets 设计生成的 FPGA 流水线中,延迟保持接近理论最小值。大多数运算符不存储完整的图像。它们在信息可用时立即转发结果。
延迟定义#
延迟 是指设计中像素的延迟——即像素从进入处理链到离开处理链(例如,直到到达 DmaToPC)。
要点:
- Latency 由每个运算符单独定义,且主要取决于其算法实现。
- 添加模块不会降低 throughput。生成的 FPGA 管道中的所有阶段均并行运行:当一个模块处理一个像素时,其他模块会处理其他像素。管道 Fill 后,更长的链仍然可以在每个时钟周期接收一个新像素(或像素数据包)。
- 添加运算符可能会增加延迟。每个运算符都可能会增加单个像素路径上的延迟,并且这些延迟会在链条中累加。与缓冲区的行或帧延迟相比,O 型运算符产生的几个时钟周期通常很小。
- 延迟与阻塞或缓冲区 Fill 级别不同。如果下游处理变慢,缓冲区可能会填满,从而进一步增加延迟。本主题介绍运算符本身内置的最小延迟。
示例设计#
以下设计贯穿本主题。它展示了一个包含一个缓冲区和两个处理步骤的简单采集路径:
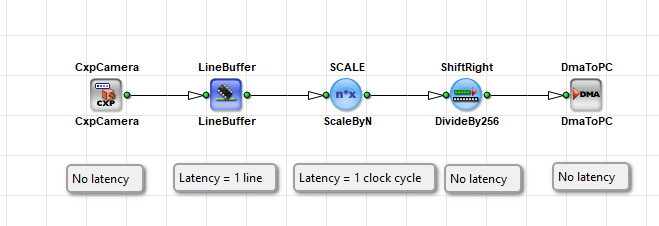
上述设计中的延迟注释适用于此特定示例:
| 算子 | 本示例中的延迟 |
|---|---|
CxpCamera | 本示例中没有额外的算法延迟 |
LineBuffer | 1 行 |
ScaleByN | 1 个时钟周期 |
ShiftRight | 无额外延迟 |
DmaToPC | 本示例中没有额外的算法延迟 |
此路径上像素的总延迟主要由 单行延迟 的 LineBuffer的单行延迟以及其他运算符的少量处理延迟决定。“No additional algorithmic latency”对于 CxpCamera 和 DmaToPC 意味着这些运算符在此示例中不会增加额外的此类延迟。这并不意味着像素会立即出现在 PC 上。相机接口时序、PCIe 传输、主机缓冲和显示不在本表范围内。
示例设计中的像素流#
在示例设计中,像素通过相机接口从相机传输至 LineBuffer。该 LineBuffer 在将数据转发到输出端之前,收集完整的一行数据。
将完整的一行存储在 LineBuffer决定,缓冲区输出该行的像素。在 同时相机已经传输了 下一行。这就是生成的 FPGA 硬件的流水线行为:采集、缓冲、处理和 DMA 可以重叠。VisualApplets 描述了该流水线;它本身不处理相机数据流。
计算延迟#
延迟取决于运算符。整个设计没有单一的数值。您需要累加(或按时间跟踪)单个像素路径上的延迟。
基于行的延迟(缓冲运算符)#
诸如 ImageBuffer 和 LineBuffer 至少需要 整整一行 才能输出该行的第一个像素。对于 LineBuffer :
Latency = 1 行
以时间衡量,一行的延迟为:
Line latency = (每行像素数)/(链路像素速率)
像素速率取决于 Parallelism 和 Base Design Clock。更宽的行或更慢的链路会增加第一个像素离开缓冲区所需的时间。
时钟周期延迟(处理运算符)#
许多处理运算符会延迟像素固定的时钟周期数。流水线填满后,它们仍可在每个时钟周期接受并输出一个像素(或一个并行像素包)。单个像素的延迟此时仅为这些内部寄存器级数。
在示例设计中, ScaleByN 增加了:
Latency = 1 个时钟周期
以时间衡量,一个时钟周期的延迟为:
Cycle latency = 1 / Base Design Clock 频率
例如,在 312.5 MHz 的 Base Design Clock 下,一个时钟周期为 3.2 ns。
诸如 ShiftRight 在此示例中,添加 没有实质性延迟 在实践中。它们一旦获得输入值就会转发结果。
运算符类型与延迟#
VisualApplets 将算子按类型进行分组。类型有助于您估计延迟:
| 键入 | 图标形状 | 典型延迟行为 |
|---|---|---|
| O 型 | 圆形 | 非常小且固定的延迟 — 通常为恒定的时钟周期数。例如:延迟约为 3.2 ns(312.5 MHz 基础设计时钟下的一个周期)。 |
| M 型 | 正方形 | 可变延迟。可缓冲行或帧,更改图像尺寸,或阻塞输入。请查阅操作员文档以了解确切的延迟。 |
| P 型 | 正方形 | 与 M 型类似,但不会主动阻塞输入。具体延迟请查阅操作文档。 |
CxpCamera, LineBuffer和 DmaToPC 是 M 型算子。 ScaleByN 和 ShiftRight 是 O 型算子。尽管 DmaToPC 是 M 型,但在该示例中它不会增加太大的算法延迟——它会在数据到达时立即将数据传递给 DMA。直到图像在主机软件中可见这段时间是后续的独立延迟。
关键术语
可以将 O 型算子视为具有固定长度的短管道区段。可以将 M 型算子视为包含储罐(缓冲区)或更复杂机械的区段。储罐必须先充满,第一滴水才会流出——这就是基于行的延迟。这些管道和储罐是 FPGA 上的硬件级,由您在 VisualApplets 中放置的模块生成。
Parallelism 与延迟#
Parallelism并不能消除延迟,但它可以提高带宽:每个时钟周期内,链路上传输的像素数量更多。
例如:并行度为 4 时,一个时钟周期内有四个像素通过链路。 第一个像素 帧的某一部分仍然需要相同的操作延迟,例如,一行 ImageBuffer中的一行。管道满载后,四个新像素可以在每个时钟周期离开算子。
- 高并行性→ 高吞吐量(带宽)。
- 缓冲区和算法→ 第一个像素的延迟。
这两个性质是相互独立的。 VisualApplets 设计目标是在生成的 FPGA 流水线中实现高带宽和最小延迟。
查找运算符的延迟值#
要查找要在设计中使用的算子的延迟值,请使用以下来源:
- 运算符参考— 每个运算符都在运算符参考中记录其延迟(或处理延迟)。
- 产品内帮助— 在设计中选择运算符,即可打开帮助以查看参数和时序详细信息。此内容与工具内帮助中提供的“运算符参考”相同。 VisualApplets 。
特别是对于 M 型算子,请务必检查文档。延迟可能取决于参数(例如,滤波器算子中的内核大小,或 Memory 算子中的缓冲区深度)。
大多数算子不会存储完整图像。只要信息可用且输出未被阻塞,它们就会计算输出结果。这就是生成的 FPGA 管道中的延迟保持接近所选算法的理论最小值的原因。
例如,如果由于计算机无法足够快地接收数据而导致输出阻塞,则缓冲区填充率会增加,像素出现在主机上的时间也会增加。这种额外的延迟并非固定的操作延迟,而是来自负载下的流量控制和缓冲。
相关主题#
- 流水线概念教程主题——无缓冲流和并发处理
- Parallelism教程主题——并行性和延迟
- 运算符类型和同步教程主题——运算符类型和延迟
- 内存元素教程主题——缓冲区运算符的行延迟
- 内核使用教程主题——内核相关延迟
- 用户手册中关于小程序带宽的说明——带宽与延迟的关系
- 运营商参考值— 各个运营商的延迟值
- Device Resources — 基础设计时钟频率