Parallelism#
关键术语
Base Design Clock 是采集卡上生成的 FPGA 流水线时钟,例如 312.5 MHz。它与相机像素时钟不同,也不是 VisualApplets 编辑器内部的时钟。时钟周期是 Base Design Clock 的一个脉冲。在每个时钟周期内,可以通过链路传输一定数量的像素。该数量即为 parallelism。Parallelism 4 意味着每个时钟周期传输四个像素。较高的 Base Design Clock 频率或更高的 parallelism 会提高像素速率,本主题将其称为带宽。
Parallelism 与带宽#
Parallelism 是指在生成的 FPGA 流水线的链路中,每个时钟周期流过的像素数量。
Parallelism 会影响模块内部的处理粒度。例如, LineBuffer 参数 XLength 取决于 Parallelism。
适用以下规则:
- 更高的 Parallelism → 更高的像素速率带宽。
- 更高的 Parallelism → 更高的 FPGA 资源占用。
位宽和核大小不包含在此像素速率数值中。它们会增加每个时钟周期的数据量,这对于 DRAM 和资源非常重要。请参阅处理核教程主题和内存元素教程主题。
设计指南
将 Parallelism 保持在不高于必要的水平,以节省 FPGA 资源。
作为像素速率的链路带宽遵循以下公式:
带宽 = Parallelism × Base Design Clock
Base Design Clock 取决于您使用的采集卡。对于 Basler 采集卡,请在设备资源中查找该值。
关键术语
您可以使用“链路信息”和“吞吐量”标志,在设计中显示并行性和数据吞吐量。使用工具栏中的以下按钮激活这些标志:
因此,您的设计中会显示 Link Info 和 Throughput 标志:
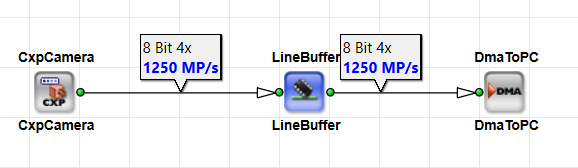
在本主题中,我们展示的所有设计截图均启用了 Link Info 和 Throughput 标志。
计算所需的 Parallelism#
要确定设计的尺寸,首先计算所需的像素速率,然后从 Base Design Clock 推导出所需的 Parallelism。
计算面阵扫描设计的 Parallelism#
对于使用面阵相机的设计,首先以每秒像素数计算带宽:
带宽 = (每行像素数)×(每帧行数)× 帧率
然后使用带宽计算所需的 Parallelism:
所需的 Parallelism = 带宽 / Base Design Clock
选择至少与计算要求一样大的受支持的最小 Parallelism。向下取整会使设计低于所需的带宽。例如,在 Base Design Clock 为 312.5 MHz 时,6000 MP/s 需要 19.2 的 Parallelism。Parallelism 19 只能提供 5937.5 MP/s,这是不够的。请使用 20,或您的平台允许的下一个更高值。
面阵扫描计算示例#
对于分辨率为 2064 × 2064 像素且帧率为每秒 30 帧的相机,适用以下带宽计算:
带宽 ≈ 2064 × 2064 × 30 ≈ 127.9 MP/s
在 Base Design Clock 为 312.5 MHz 的情况下,这会导致以下计算出的 Parallelism:
所需的 Parallelism ≈ 127.9 / 312.5 ≈ 0.41 → 向上取整为 1
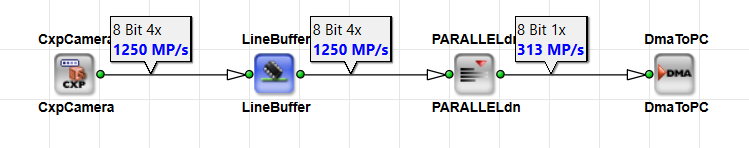
上面的截图显示了相应的 VisualApplets 设计实现。处的 parallelism 相机接口 设为 4。该值并非带宽计算所得的处理 Parallelism 。 CxpCamera 运算符会根据以下定义的 CXP 连接数量自动设置接口 Parallelism: ConnectionCount 模块参数(在这种情况下, x1)自动设置接口 Parallelism 。接口 Parallelism 与所需的处理 Parallelism 是不同的数值。由于所需的处理 Parallelism 为 1,因此链路 Parallelism 在 1 的输出链路上降低至 LineBuffer 算子。
在低帧率下, Parallelism 值为 1 即可满足要求。在较高帧率或分辨率下,所需的 Parallelism 会增加。请计算该值,然后将其向上取整至下一个支持的级别,例如: 2, 4或 8)。如果平台需要 偶数 Parallelism,请先向上取整,然后选择下一个更高的有效偶数值。例如,如果计算结果为 6.3,请使用 8,而不是 7.
计算线阵扫描设计的 Parallelism#
对于采用线扫描相机的设计,请首先计算每秒像素数的带宽:
带宽 =(每行像素数)× 行频
然后使用带宽计算所需的 Parallelism:
所需的 Parallelism = 带宽 / Base Design Clock
根据您的平台规则和允许的 Parallelism 值,将结果向上取整。
线阵扫描计算示例#
对于分辨率为 16384 像素且行频为 120 kHz 的相机,适用以下带宽计算:
带宽 ≈ 16384 × 120 kHz ≈ 1966.08 MP/s
在 Base Design Clock 为 312.5 MHz 的情况下,这会导致以下计算出的 Parallelism:
所需的 Parallelism ≈ 1966.08 / 312.5 ≈ 6.3 → 向上取整为 7
计算结果为 6.3,因此下一个整数是 7)。如果平台需要 偶数 Parallelism,请选择下一个更高的有效偶数值(8,而不是 7)。下方的截图使用了 Parallelism 7,这在不需要偶数 Parallelism 时是有效的。
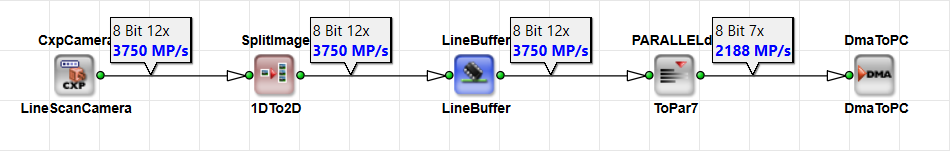
上方截图展示了相应的 VisualApplets 设计实现。相机接口处的 Parallelism 设置为 12。该值由 CxpCamera 运算符根据 CXP 连接数量(ConnectionCount 参数设置为 x2)。此接口 Parallelism 同样与所需的处理 Parallelism 不同。 SplitImage 运算符执行 1D 到 2D 转换。随后, LineBuffer 运算符将链路 Parallelism 降低至 7 ,以匹配计算出的处理需求。
更改设计中的 Parallelism#
以下运算符将设计的 Parallelism 调整为符合 带宽要求:
增加或减少 Parallelism#
PARALLELdn— 减小 Parallelism。参见 PARALLELdn 中的 Operator Reference。PARALLELup— 增大 Parallelism。参见 PARALLELup 中的 Operator Reference。- LineBuffer(仅限 imaFlex): 即:
ParallelismConverter算子的LineBuffer运算符可在输入和输出之间调整 Parallelism,而无需附加的 Parallelism 运算符。参见 LineBuffer (imaFlex) 中的 Operator Reference。
拆分、选择和合并流#
SplitParallel— 将一个具有较高 Parallelism 的数据流拆分为多个具有较低 Parallelism 的数据流。示例:Parallelism8变为两个数据流,每个数据流的 Parallelism 为4每个。另请参阅 SplitParallel 中的 Operator Reference。SelectFromParallel— 从并行流中选择单个组件,例如每个时钟周期传输的多个数据字中的一个。另请参阅 SelectFromParallel 中的 Operator Reference。MergeParallel— 分别处理后再次合并并行流。另请参阅 MergeParallel 中的 Operator Reference。
其他算子#
CastParallel— 重新解释链路上的位。只要 Bit Width × Parallelism 输入和输出保持相等,Parallelism 和 Bit Width 可能会改变。例如:16 bit × PAR 2 变为 8 bit × PAR 4。图像宽度会相应更改。另请参阅 CastParallel 中的 Operator Reference。ExpandToParallel— 接收 Parallelism 为 1 的输入并生成所需的输出 Parallelism。输入值将复制到所有并行通道。另请参阅 ExpandToParallel 中的 Operator Reference。
用例#
以下是用例中经常出现的场景:
-
使用
PARALLELup以提高 Parallelism,在并行分支中处理数据,并使用MergeParallel.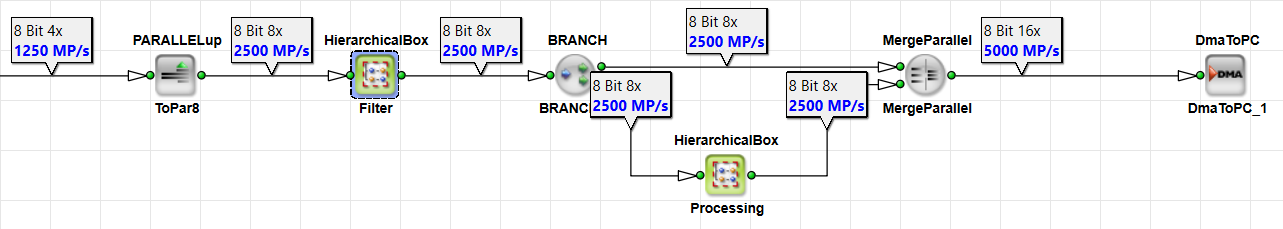
-
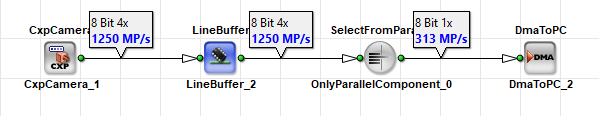
再次合并分支。对于某些处理任务,在数学上只需选择一个组件即可获得所需的结果,同时减少数据量。使用
SelectFromParallel仅转发来自 Parallelism4流的一个通道。
- 在
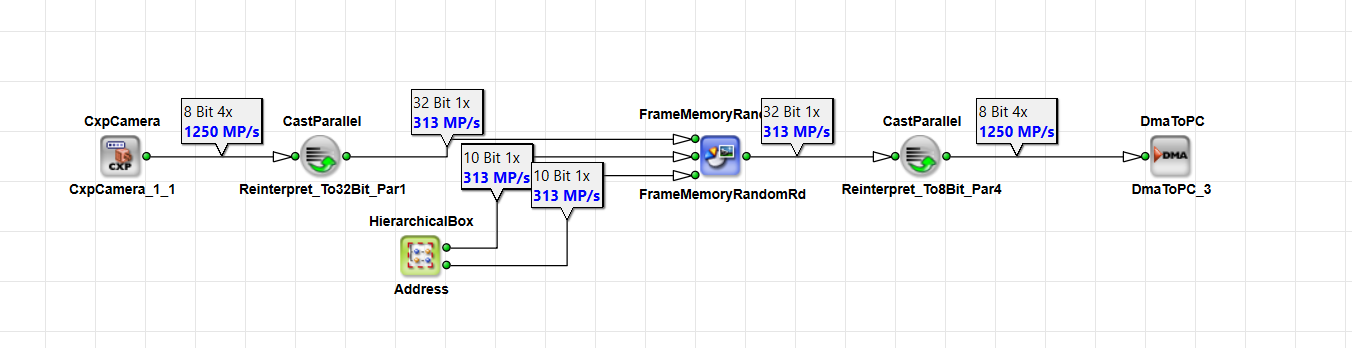
FrameBufferRandomRead之后1,数据流以 Parallelism 运行,例如每像素 64 bit。为了使下游处理以更高的 Parallelism 运行,可将数据流重新解释为 8 bit × Parallelism8为此,请使用CastParallel算子。
- 使用
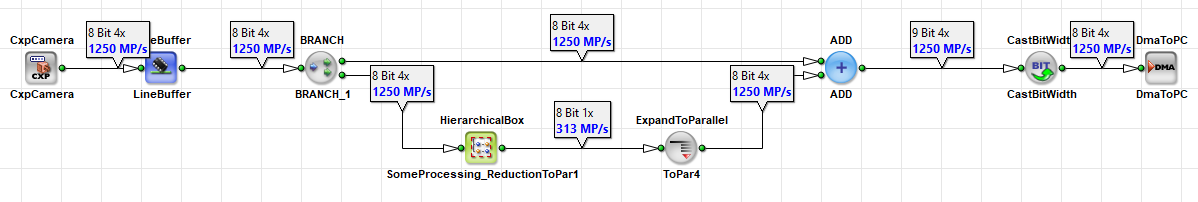
ExpandToParallel以使用 Parallelism 扩展控制值或像素流1至 Parallelism4当必须在所有四个并行通道中都可用相同的值时(例如并行分支中的系数或掩码)。
Parallelism 限制#
以像素为单位的 最大图像宽度 必须 能被 Parallelism 整除。
示例:
- 在 Parallelism 为
4时,允许的图像宽度包括 1024 和 2048。 - 在 Parallelism 为
12,图像宽度为 16384 是 不 允许的,因为 16384 / 12 不是整数。
变通方法:
- Dummy pixels — 增宽图像(例如通过仿真链接 Property 或算子),直到图像宽度能被 Parallelism 值整除。
- Crop — 将图像裁剪为有效的图像宽度。
关键术语
生成的 FPGA 硬件按每个时钟的数据包处理像素。16384 像素的行无法完全塞入 Parallelism 12 中,因为 16384 / 12 不是整数。因此,VisualApplets 要求设计中的图像宽度必须能被 Parallelism 整除。
带内存算子的 Parallelism#
FrameBufferRandomRead 仅允许 Parallelism 1,因为内存是按顺序访问的。要在设计中使用更高的 Parallelism 且不影响整体带宽,请使用以下工具将并行组件转换为内核组件: CastKernel 算子将并行分量转换为内核分量,或使用 CastParallel 算子。
有关如何执行此操作的示例,请参见 Working with Kernels 教程主题。
请参阅算子参考中的 FrameBufferRandomRead 以及算子参考中的 FrameBufferRandomRead (imaFlex)。
故障排除与瓶颈分析#
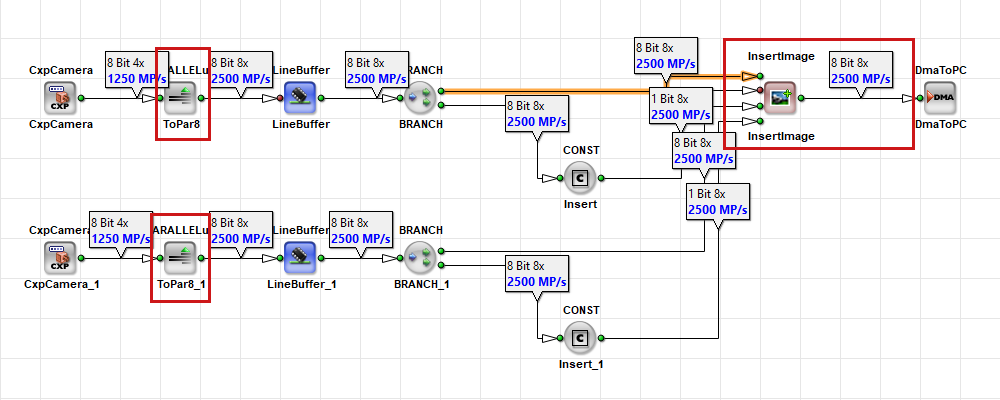
典型瓶颈出现在 InsertLine 算子参考中的 InsertImage 或算子参考中的 PARALLELup结合使用时,通常会出现瓶颈。
使用插入算子会增加输入到处理流水线的数据量,从而提高整体带宽。因此, InsertLine 或 InsertImage 算子之后的 Parallelism 必须足够高,以处理由此产生的带宽。
示例#
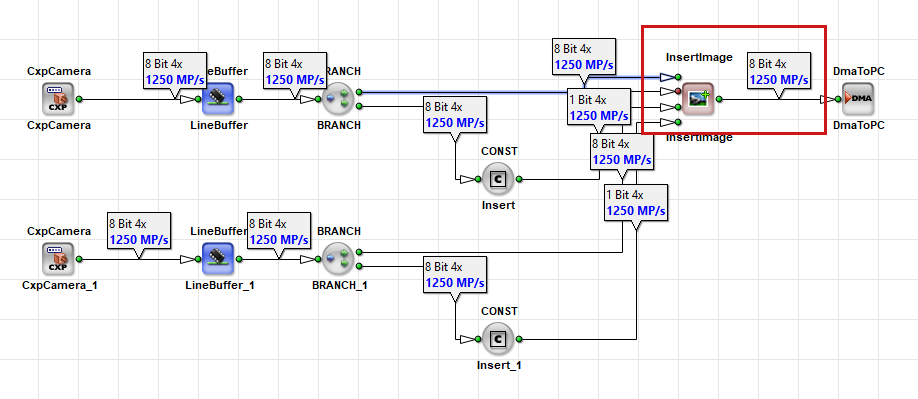
上图中的示例表明, InsertImage 算子有两个输入链路。每个输入链路以 1250 MPixel/s 的带宽处理分辨率为 5120 × 5120 像素的图像,使用的 Parallelism 为 4。
如果在 InsertImage 算子之前未增加 Parallelism,则每个输入的带宽仍保持 1250 MPixel/s。但是,由于有两个输入链路,设计必须处理 2 × 1250 MPixel/s 的综合吞吐量。
为避免此带宽瓶颈,请使用以下工具增加 Parallelism: PARALLELup 运算符之前 InsertImage 运算符,如下图所示:
相关主题#
- Pipeline Concept 教程主题 — 吞吐量、瓶颈和链路容量
- 参数化 教程主题 —
Parallelismlink property - Memory 元素 教程主题 — RAM 数据宽度和
LineBuffer并行度转换 - Working with Kernels 教程主题 — 内核大小与 Parallelism
- Latency 教程主题 — Parallelism 与延迟
- 用户手册中的 Bandwidth of an Applet — 正式带宽定义
- Device Resources — 基础设计时钟频率
- 用户手册中的 Bandwidth Bottlenecks — 算子排序与瓶颈