Memory 元素#
This topic explains how memory operators in a VisualApplets design map to physical memory on the target hardware, and when you use which type. After you have read this topic, you understand the difference between FPGA-internal memory (for example block RAM) and frame grabber DRAM, how FIFO-style buffers differ from random-access frame buffers, how shared DRAM bandwidth limits designs with several RAM operators, and how you recognize memory-related problems in simulation and on hardware.
关键术语
FillLevel tells you how full a buffer is (in percent) at runtime on the hardware, for example in microDisplay X. A buffer that stays near 100% often points to a bottleneck or deadlock. As a starting point, place a buffer after the camera.
For platform RAM sizes, data widths, and bandwidth values, see Device Resources.
FPGA Memory vs. Frame Grabber DRAM#
VisualApplets memory operators fall into two groups by where they store data on the frame grabber. A second distinction is how they access that data: FIFO-style buffers versus random-access or multi-ROI frame buffers. The Overview of the Memory Library in the Operator Reference shows where each memory operator stores its data. The RAM resource in VisualApplets is a device-resource token that maps to board DRAM. It is not memory inside the VisualApplets application.
| Property | FPGA-internal memory | Frame grabber DRAM |
|---|---|---|
| Typical operators | ImageFifo; 对于小型随机访问情况也适用 FrameMemoryRandomRd / LineMemoryRandomRd | ImageBuffer, LineBuffer, FrameBufferRandomRead, FrameBufferMultiRoi, FrameBufferMultiRoiDyn |
| Location | Inside the FPGA (BRAM, LUT RAM, or URAM on imaFlex CXP-12 Quad/Penta) | On the board, outside the FPGA |
| 容量 | 有限;全分辨率帧通常会超出可用的 FPGA memory | 较高;适用于许多行或整帧 |
| 延迟 | 低;无法访问外部 DRAM 总线 | 面向行的 FIFO 至少会增加一行 |
| VisualApplets RAM 资源 | 否 — 不预留 RAM 设备资源 | 是 — 每个实例一个 RAM 资源,映射到板载 DRAM |
| 带宽 | 本地;算子不会争夺采集卡 RAM 接口 | 在同一物理接口上的 RAM 算子之间共享 — 参见 Sharing DRAM Bandwidth |
使用 Choosing a Memory Operator 中的表格选择一个算子,然后阅读相应的算子部分以了解参数和平台详情。
Choosing a Memory Operator#
| 用例 | 首选 |
|---|---|
| 小缓冲区,低延迟,无 DRAM 带宽成本 | ImageFifo (FPGA 内部) |
| mE5 上的 Image FIFO,峰值吸收,ROI | ImageBuffer (DRAM) |
| imaFlex CXP-12 Quad/Penta 上的 Line FIFO | LineBuffer (DRAM) |
之前的缓冲区 SYNC 具有较小的延迟 | ImageFifo (如果延迟较大,则使用更大的 DRAM 缓冲区) |
| 带随机像素读取的全帧存储 | FrameBufferRandomRead (DRAM) |
| 来自一个缓冲区的多个或动态 ROI | FrameBufferMultiRoi / FrameBufferMultiRoiDyn (DRAM) |
设计指南
Basler 建议您在设计中至少使用一个 DRAM 算子,以补偿来自相机的突发数据。该 DRAM 缓冲区是默认的相机解耦路径(LineBuffer 或 ImageBuffer)。 ImageFifo 当您需要吸收来自相机的突发数据时,它不能替代该 DRAM 缓冲区。
ImageFifo#
即: ImageFifo 算子将图像数据排队为 先进先出 FPGA 内部 memory 中的缓冲区。您可以使用以下工具调整缓冲区大小 EntitiesToStore 和 EntityType Property。 EntityType 具有以下值 PIXEL, LINE或 FRAME。当输出空闲时,数据立即被转发。当下游模块阻塞时,缓冲区会填满。
设置 InfiniteSource 算子的 ImageFifo 算子到 ENABLED 当输入来自相机等不可停止的源时。
信息
即: ImageFifo 运算符仅缓冲相对少量的像素。因此,存在出现 FIFO 溢出的重大风险,而该运算符内部并不总能以稳健的方式处理这种情况。对于不可停止的数据流,Basler 建议将 ImageFifo 与前置的 Overflow 运算符结合使用,或者使用 ImageFlowControl 运算符来代替 ImageFifo 算子轻松实现。 ImageFlowControl 运算符,它将 FIFO 缓冲与集成的溢出处理结合在一起。
通过参数 ImplementationType ,您可以选择 AUTO (默认)、 BRAM, LUTRAM,或者 — 在 imaFlex CXP-12 Quad/Penta 上 — URAM. Basler recommends that you always use AUTO ,除非特定的 FPGA 资源类型短缺。
有关该算子的详细信息,请参见算子参考中的 ImageFifo。
ImageBuffer and LineBuffer#
即: ImageBuffer (microEnable 5)和 LineBuffer (imaFlex)算子的工作方式类似于 面向行的 FIFO:一旦下游模块能够接收,所选 ROI 中的完整行就会被转发。延迟至少为 一行。如果由于输出受阻而导致缓冲区填满,延迟会增加。另请参阅 延迟 教程主题。
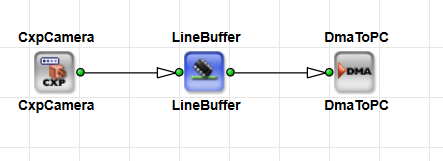
Platform Note: ImageBuffer vs. LineBuffer#
| 算子 | 平台 |
|---|---|
ImageBuffer | microEnable 5 (mE5) |
LineBuffer | imaFlex CXP-12 Quad / Penta |
imaFlex CXP-12 Quad 和 Penta 不支持 该 ImageBuffer 算子。当您将设计从 mE5 转换到 imaFlex 时,VisualApplets 会 替换 每一个 ImageBuffer 运算符替换为 LineBuffer 算子轻松实现。 LineBuffer 运算符,以为 imaFlex 平台提供相同的核心缓冲和 ROI 功能。
Defining Regions of Interest (ROI) with ImageBuffer and LineBuffer#
通过 ImageBuffer 和 LineBuffer 运算符,您还可以定义兴趣区 (ROI)。您可以通过设置 XOffset, XLength, YOffset和 YLength 参数来做到这一点。边界情况记录在运算符参考手册中:例如,如果输入小于请求的 ROI,或者如果您的设计处于 Line1D 模式,或者当您的额外像素具有未定义的内容时。
有关该算子的详细信息,请参阅《Operator Reference》中的 LineBuffer 以及《Operator Reference》中的 ImageBuffer。
Monitoring Buffer Usage and Overflow#
即: ImageBuffer 和 LineBuffer 算子提供以下状态参数来监控缓冲区使用情况和溢出:
| 参数 | 含义 |
|---|---|
FillLevel | 以百分比形式定义缓冲区 RAM 的满载程度(在 ImageBuffer 中以 25% 的步长)。 |
LineCount | 指示当前存储的行数。仅适用于 LineBuffer 算子。 |
Overflow | 指示缓冲区无法接收更多数据而不会超出容量。此状态参数与 Synchronization 库中的 Overflow Synchronization 库中的算子,这与算术溢出不同。另请参阅 可停止与不可停止的数据流 教程主题和 位算术 教程主题。 |
如果发生溢出,可能会丢弃传入的数据,并且有效图像高度可能会减小。在算子恢复之前,不完整的图像可能会一直保留在 Memory 中。 Overflow 适用于源不可停止且 InfiniteSource 的值为 ENABLED的情况。设置 InfiniteSource 更改为 ENABLED 缓冲区直接位于相机或其他无限源之后的情况。另请参阅 可停止与不可停止的数据流 教程主题。关于如何在调试时使用这些参数,请参阅 Recognizing Memory-Related Errors.
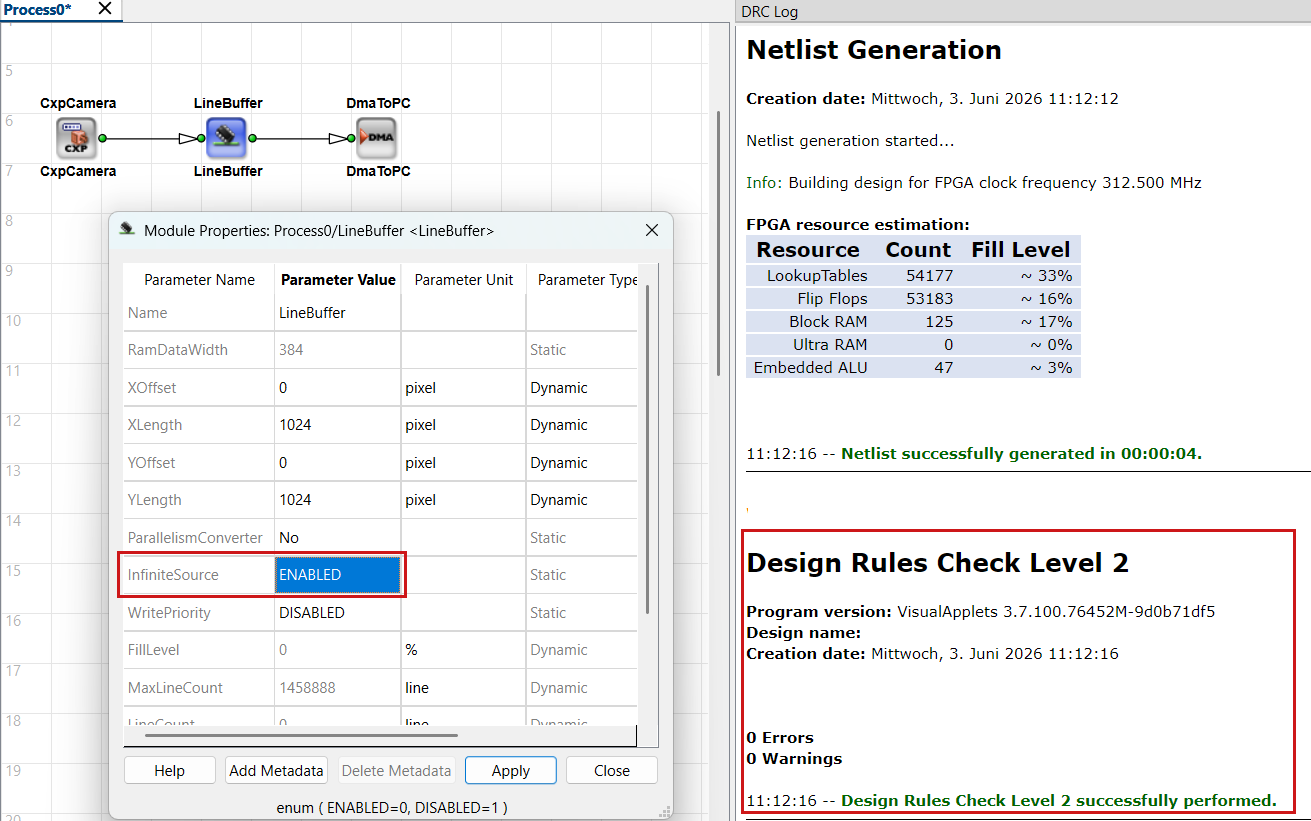
在 LineBuffer 算子,Basler 建议启用 WritePriority 参数,当 InfiniteSource 的值为 ENABLED。如果 WritePriority 的值为 ENABLED当临时写入速率超过可用DRAM带宽时,相机优先采用写入突发而非读取操作。 平均的 带宽仍须保持在运营商可用的份额范围内。
即: LineBuffer 算子还可以通过模块参数在输入和输出之间转换 Parallelism ParallelismConverter,因此您并不总是需要一个单独的 PARALLELup / PARALLELdn另请参阅 Parallelism 教程主题。
Full Frames, Random Access, Multi-ROI with the FrameBuffer Operators#
即: FrameBufferRandomRead, FrameBufferMultiRoi和 FrameBufferMultiRoiDyn 运营商商店 完整图像或大区域 并按照以下顺序读取它们: 不 严格的行 FIFO。当您需要对来自单个缓冲区的像素进行随机访问或使用 Multiple ROI 时,请使用它们。
FrameBufferRandomRead#
FrameBufferRandomRead 将输入图像写入 DRAM,然后通过以下方式读取像素: 列和行地址 在专用的地址端口上。将其用于几何变换、重映射和其他随机访问模式。
对于小画面或行,建议使用 FPGA 内部算子,例如 FrameMemoryRandomRd 或 LineMemoryRandomRd ,而不是 DRAM 算子。
有关该算子的详细信息,请参阅算子参考中的 FrameBufferRandomRead。
FrameBufferMultiRoi and FrameBufferMultiRoiDyn#
即: FrameBufferMultiRoi 和 FrameBufferMultiRoiDyn 算子存储图像数据并输出 多个感兴趣区域. FrameBufferMultiRoiDyn 允许 动态 来自控制链接的 ROI 大小和位置。
Sharing DRAM Bandwidth#
每个 DRAM 算子都需要一个类型为 RAM 的 VisualApplets 资源。该资源是 VisualApplets 资源模型中的一个插槽。它映射到采集卡上的物理 DRAM。在 imaFlex 和 microEnable 5 marathon 平台中,所有预留 RAM 资源的算子共享物理 DRAM。每个算子都会获得一个专用的、不重叠的内存区域,但大小和带宽会在同一物理接口上处于活动状态的 RAM 算子之间进行分配。
后果:
- 每一个读操作和每一个写操作都会消耗共享接口上的带宽。
- 当存在多个 DRAM 实例或高吞吐量时,总流量可能会超出平台限制。
- 过量的需求会导致阻塞、上升
FillLevel、溢出或降低可持续帧率。
在设备资源中查找您的平台的 RAM 大小、RAM 数据宽度和RAM 带宽总计(共享)。
在需要时在资源对话框中分配资源;请参阅设备资源中的设备资源的分配。
Bandwidth Calculation Notes#
共享内存应用说明解释了如何高效使用 RAM 大小和 RAM 数据宽度。
要点:
-
读写操作共享接口。对于单个 DRAM 算子,在估算可用图像数据速率时,请将平台最大带宽除以 2(一半用于写入,一半用于读取),然后应用效率系数。文档中记录的带宽值为理论最大值;实际效率较低。
-
尽可能多地利用 RAM 数据宽度。该链接的有效 RAM 数据宽度为:
bit width × Parallelism × kernel elements
该乘积是每次 DRAM 访问的有效宽度。切勿将其与来自 Parallelism × Base Design Clock 的像素速率带宽混淆。当乘积与平台的 RAM 数据宽度匹配且不超过该宽度时(例如根据板卡型号为 256 位、384 位或 640 位),即可达到最大的 DRAM 吞吐量。将乘积与最大 RAM 数据宽度相匹配可以充分利用 DRAM 的读写带宽;如果该值太低,DRAM 访问可能会成为瓶颈。采用 8 位 × Parallelism 4 的设计仅使用了 256 位接口中的 32 位,从而浪费了带宽余量。
-
多个 DRAM 算子共享带宽。在共享内存平台上,单个算子可用的带宽大致与该接口上的 1 / (RAM 算子数量) 成正比。具体细节因平台而异,如设备资源和应用说明:共享内存(另请参阅相关主题)中所述。
-
当平台提供多个物理接口时(例如 imaFlex 2 Dual 100),请在独立的 RAM 银行(Bank)之间平衡算子。带宽仅在同一物理银行上的算子之间共享。
设计指南
尽早规划 RAM 的使用。每个额外的 DRAM 算子都会减少同一物理内存接口上其他算子可用的带宽。在添加另一个 DRAM 缓冲区之前,请计算组合的读/写流量,并将其与您平台可用的共享带宽进行比较(参见 Device Resources)。建议优先选择 ImageFifo (FPGA 内存)来处理小型解耦任务,以免不必要地消耗 DRAM 带宽。
Recognizing Memory-Related Errors#
VisualApplets 并不总是能够验证某个设计是否针对每种运行场景都拥有足够类型和大小的内存。您必须选择与您的图像尺寸、速率和同步需求相匹配的算子和缓冲区大小。
即使缓冲区对于硬件而言过小,仿真也可能会成功运行。故障通常仅在采集卡上显现:例如,尽管仿真看起来很正常,但 SDK 中没有输出图像。
常见原因包括 SYNC 死锁 和 内存不足或内存错误.
为避免这些问题,请执行以下检查:
- 在布线缓冲区和 DMA 路径后,运行 Design Rules Check Level 1 and Level 2。
- 在硬件上监控
FillLevel(以及Overflow(如适用),例如在 microDisplay X 中。持续达到 100% Fill 通常表示发生死锁或带宽瓶颈。 - 使用多个 DRAM 算子时,打开 Design → Device Resources 并验证 RAM 分配及预期带宽份额。
- 对于无限数据源,请确认
InfiniteSource的值为ENABLED已应用于接收不可停止数据流的每个缓冲区。
典型流水线示例#
Camera to DMA Through a DRAM Line Buffer#
最小的可能设计包含一个相机算子、一个带有 InfiniteSource 设置为 ENABLED的 DRAM 缓冲区 DmaToPC 算子输出链路上的 Bit Width:
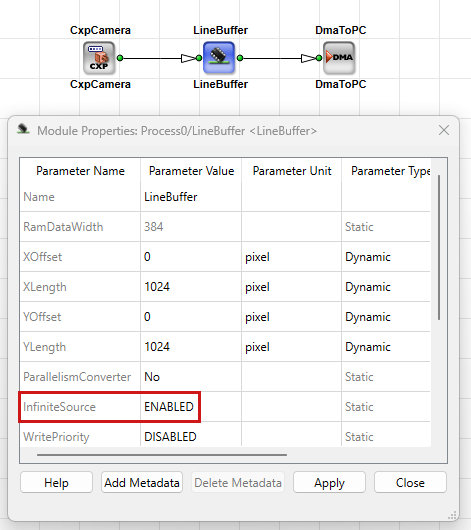
以及一个 FillLevel 在硬件上;该值如果保持在 100% 附近,通常表示存在瓶颈或死锁。参见 Recognizing Memory-Related Errors.
Camera Through LineBuffer into a 3×3 Kernel#
;持续接近 100% 的值通常表示存在瓶颈或死锁。请参阅“识别与内存相关的错误”。 LineBuffer 算子的共享 DRAM 带宽。截图中的 Design Rules Check 确认了在生成之前链接格式和缓冲区设置是一致的。
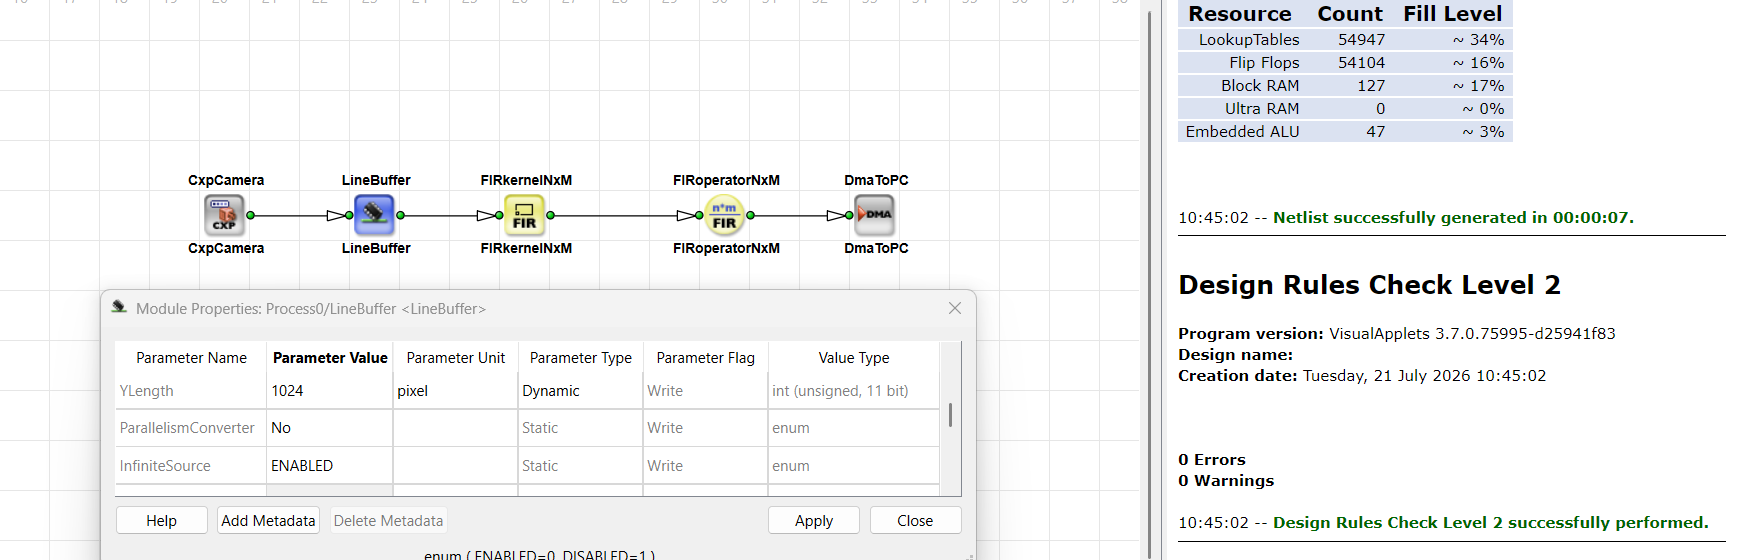
相关主题#
- 可停止与不可停止的数据流 教程主题 —
InfiniteSource、溢出、相机解耦 - Parallelism 教程主题 — 带宽、RAM 数据宽度、
LineBuffer并行度转换 - Latency 教程主题 — 缓冲区算子的行延迟
- 算子类型与同步 教程主题 — 前端缓冲区
SYNC - Device Resources — 平台 RAM 和 Shared Memory 概念
- Shared Memory 应用笔记 — 高效 DRAM 使用及带宽示例
- 算子参考中的 Memory Library — 按内存类型划分的算子概述