OCR vTool#
光学字符识别的主要目标是识别图像中的物体,或读取物体上的特定信息,例如保质期、序列号或产品标签。
OCR vTool 通过 Image 输入引脚接收图像。文本和所得单词的分割区域通过 Texts 和 Regions 输出引脚输出。
要购买 OCR vTool 的许可证,请访问 Basler 网站。
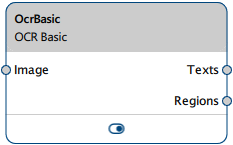
运作原理#
在指定的感兴趣区域中,OCR vTool 将文本分割为单词和单个字符,并对每个字符进行分类(即作为字母、数字或特殊字符,例如标点符号)。
尽管名称如此,但 OCR vTool 读取的不是单个字符,而是单词。最小单词长度为 2 个字符。
如果您的文本跨越多行,则每一行至少被视为一个单词。如果单行内的单词之间存在较大空隙,算法会将这些单词视为不同的实体。
一个 4 步向导将引导您完成 vTool 的配置。它可以就您的设置产生的影响提供即时反馈。请参阅以下部分以了解有关各个步骤的更多信息。
预览区域#
预览区域是一个实用的工具,可用于立即检查您在 vTool 设置中所做的任何更改。
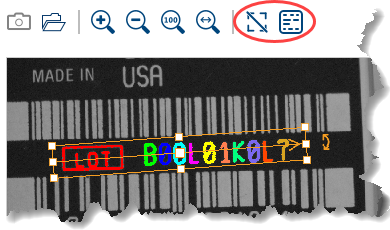
预览区域上方有两个按钮,一个用于切换分割区域和识别字符周围边界框的显示,另一个用于高亮显示区域。
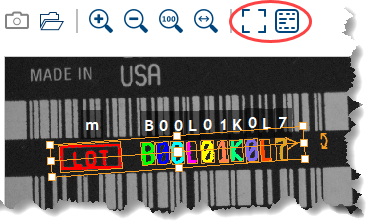
显示边界框和识别出的字符#
通过此按钮可以显示/隐藏分割区域周围的边界框:

在每个识别出的字符上方会显示其结果字符。这有助于您快速验证识别过程是否正确。
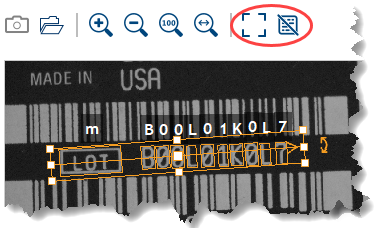
高亮显示区域#
通过此按钮可以高亮显示分割区域:

这使得更容易观察字符是被完全识别还是仅部分识别。这有助于微调分割设置,例如对比度。
步骤 1:初始设置#
首先加载一张合适的示教图像,可以从磁盘加载,也可以使用实时相机图像。示教图像在以下方面必须具有检测图像的代表性:
- 文本的位置和方向
- 字符的大小(如果您是手动指定字符尺寸)
在自动模式下,允许字符大小发生变化。
Basler 建议在配置 OCR vTool 时使用多个不同的样本图像。通过这种方式,您可以更好地评估文本的图像 quality、检查分割结果以及候选字符的置信度。这些样本图像最好能够涵盖您在应用中期望出现的所有完整字符集。
矩形设置#
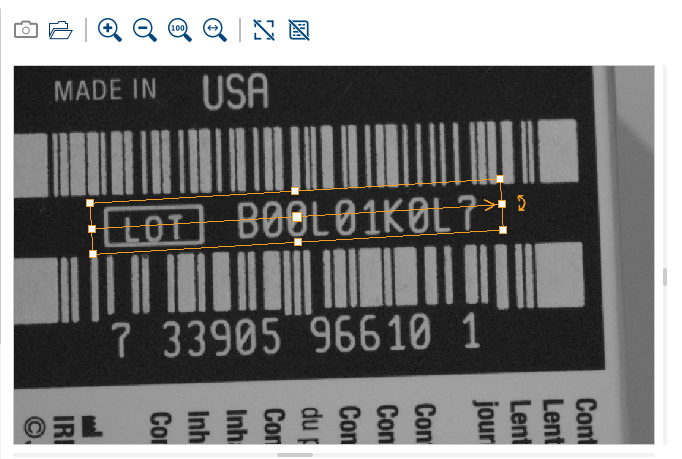
加载图像后,图像中会显示一个矩形。该矩形用于标记文本所在的区域。您可以通过拖动矩形的控点或在预览区域左侧的输入框中手动输入数值来调整其位置、方向和大小。
该区域必须仅包含您想要读取的文本,因为 OCR 算法无法区分字符和不需要的图像元素(杂波)或噪点。如果无法完全避免杂波或噪点,您应采取适当的措施,例如添加后处理步骤或添加其他 OCR vTools 以定义多个文本区域。此外,切勿将矩形框得太贴近文本,因为不同图像之间的文本可能会在各个方向上发生微小的位移。
在定义区域时,请注意穿过区域矩形的箭头。该箭头指示了读取方向。无法读取沿其他方向排列的文本。
为了使 OCR vTool 能够稳定工作,您要处理的所有图像中的文本方向应当大致相同。允许有几度以内的微小偏差。Basler 建议调整相机位置,使文本能够从左到右阅读。如果您的文本具有不同(但恒定)的方向,请相应地调整区域矩形的位置,同时确保箭头指向文本的读取方向。
如果文本位置变化很大且文本周围的背景空间有限,您应将 Image Alignment 作为预处理步骤添加,以确保文本的方向和位置稳定。
这是一个示例图像,其中矩形经过了轻微旋转以跟随文本。
字体设置#
选择适合图像中文本的字体及相应的字符集。通常,这由应用规范或打印工艺决定。
下表列出了可用字体并显示了其外观示例:
| 字体名称 | 描述 | 外观 |
|---|---|---|
| 标准混合 | 不同的字体,带或不带衬线,常用于文档中 | 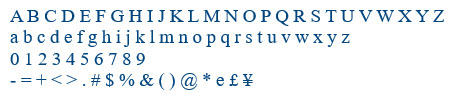 |
| 标准无衬线 | 文档中常用的无衬线办公字体 | 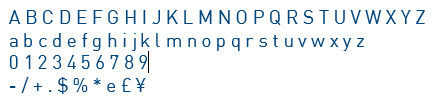 |
| OCR-A | OCR-A 标准中定义的字体 | 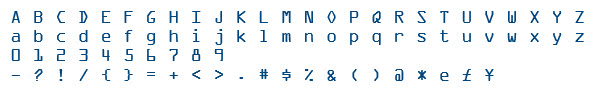 |
| OCR-B | OCR-B 标准中定义的字体 | 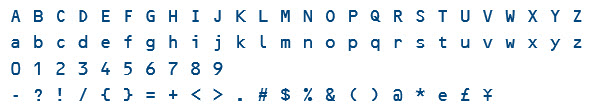 |
| 点阵打印 | 点阵打印机生成的各种点阵字体 | 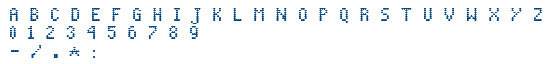 |
| Pharma | 制药行业使用的无衬线字体 | 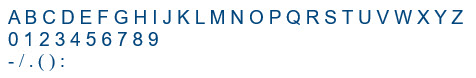 |
| SEMI | SEMI 标准中定义的半导体行业专用字体 | 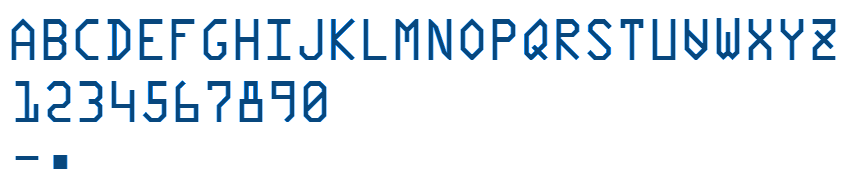 |
| 手写 | 手写数字 | 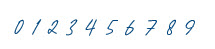 |
根据字体的不同,提供不同的字符集。字符集可以包含以下部分或全部子集:
- 大写字母
- 小写字母
- 数字
- 特殊字符
可识别的特殊字符因字体而异。
下表列出了每种字体可识别的字符:
| 字体名称 | 大写字母 | 小写字母 | 数字 | 特殊字符 |
|---|---|---|---|---|
| 标准混合 | 是 | 是 | 是 | - = + < > . # $ % & ( ) @ * e £ ¥ |
| 标准无衬线 | 是 | 是 | 是 | - / + . $ % * e £ ¥ |
| OCR-A | 是 | 是 | 是 | - ? ! / { } = + < > . # $ % & ( ) @ * e £ ¥ |
| OCR-B | 是 | 是 | 是 | - ? ! / { } = + < > . # $ % & ( ) @ * e £ ¥ |
| 点阵打印 | 是 | 无 | 是 | - / . * : |
| Pharma | 是 | 无 | 是 | - / . ( ) : |
| SEMI | 是 | 无 | 是 | - . |
| 手写 | 无 | 无 | 是 | 不适用 |
拒绝类别#
拒绝类别(rejection class)可用于处理不明确的结果,即 vTool 无法识别的字符。这些字符被归类为拒绝字符,并根据其在 pylon Viewer 中出现的位置显示为不同的问号图标。
此图标用于设置对话框中:

此图标用于引脚数据视图中:
使用拒绝类别可以更好地评估结果的置信度。除字符与训练字体的匹配程度外,置信度还反映了字符的打印或图像 Quality。
如果置信度最高的结果属于拒绝类别,则图像的这一部分无法明确分配给某个字符。这可能是由图像中的污迹或打印不完整的字符引起的。如果这种情况经常发生,则说明图像 Quality 较差。在这种情况下,您可以尝试改善图像 Quality,或者在后处理步骤中将此类字符声明为不可读。这种方法更加稳妥,因为它允许您选择置信度较低的字符。
如果您的分类结果经常出现不明确的情况,可以考虑使用正则表达式执行单词纠错。
如果您希望始终返回一个字符,请禁用 Allow rejections 选项。
为了找到适合您的设置,请尝试启用和禁用该选项,并观察步骤 4 中的结果在候选列表和识别出的单词方面有何不同。
步骤 2:字符尺寸#
字符分割依赖于对字符尺寸(即宽度、高度和笔画宽度)的一些假设。OCR vTool 支持一种自动算法,可直接从图像数据中推导这些尺寸。或者,您也可以手动指定所需的尺寸范围。20 到 30 像素之间的字符高度是合适的大小范围,但您也可以指定更大的字符尺寸。小于 20 像素的字符已无法可靠识别。
信息
如果字符的大小在文本内部或不同的图像之间有所变化,请使用自动模式。这样一来,无论大小如何,所有字符都可以被读取。
手动指定尺寸的典型用例是自动模式未能排除分割中的杂波。在这种情况下,手动指定尺寸可能会消除不需要的图像元素。
步骤 3:分割设置#
对比度#
图像中字符的分割基于阈值机制,并将指定的最小对比度值作为阈值。调整最小对比度并在预览区域中观察分割结果。使用预览区域上方的切换按钮启用区域分割视图,以获得更好的可视化效果。
选择一个最小对比度设置,在此设置下所有字符都能被正确分割和读取。最小对比度不要设置得太低,否则可能会检测到不需要的杂波。
可用的字体经过训练,仅适用于浅色背景上的深色字符。如果此 Polarity 设置符合您的应用,请使用 Dark on light 选项。
如果您的应用涉及深色背景上的浅色字符,则必须使用 Light on dark 选项。在这种情况下,图像会在预处理步骤中在内部进行反转。
如果您的应用涉及比背景更亮或更暗的文本,请选择 Both 选项。但是,OCR vTool 无法读取具有混合极性的文本。文本区域内的极性必须相同。
间距#
单词还可以包含点号、逗号、连字符等特殊字符。其中大部分是标点符号。不过,连字符和等号被视为分隔符。
在某些应用中,您可能希望读取这些字符。在这种情况下,请选择包含特殊字符的字符集,并启用 Punctuation 和 Separators 选项。
而在其他应用中,您可能更倾向于在没有标点符号或分隔符的情况下读取单词,例如在读取日期时,您只对读取数字感兴趣。因此,请选择纯数字字符集并禁用 Punctuation 和 Separators 选项。
在间距方面,您还必须考虑各个字符之间的距离。为了成功将文本分割为各个区域,字符之间必须有相当大的间距。但在实际应用中,字符往往靠得太近,导致难以区分。如果您在应用中发现这种情况,请启用 Separate touching characters 选项。
点阵打印#
点阵打印字体与所有其他字体类型不同,其字符完全由单个点而不是连续的笔画组成。为了读取点阵打印文本,OCR vTool 提供了专门的分割和分类选项。要使这些选项可用,您必须在向导的 step 1 中选择点阵打印字体。字符之间有足够大的间距且采用紧凑点阵打印方案的常规点阵打印字符可以直接读取。
对于字符之间的间距与字符内点之间的间距相近或更小的点阵打印文本,Basler 建议启用 Tight character spacing 选项。
为了成功进行分割,您还必须考虑字符各点之间的间距。在紧凑的点阵打印方案中,点靠得相当近,间距大小没有变化。启用作为默认设置的 Auto 选项可以很好地读取此类字符。在这种情况下,将使用内部自动模式。
但是,如果某些间距大于其他间距,单个字符的分割可能会失败,并且该字符会被拆分为多个区域。在这种情况下,手动使用 Max. dot gap 选项指定点之间的最大允许间距可能会有所帮助。不过,这样做可能会增加处理时间。
步骤 4:结果#
向导的最后一步为您显示一个表格,其中包含单词中每个字符位置的潜在候选字符以及置信度值。如果您点击表格中的条目,预览区域中相应的边界框将被选中,反之亦然。
通过展开下拉列表,您可以查看所有候选字符。它们按置信度降序排列。这使您可以评估字符分类的总体置信度,并向您显示潜在的替代项。
信息
置信度是一个介于 0 和 1 之间的值。它表示字符识别的工作效果。非常好的分类结果通常具有高于 0.99 的置信度值。低于 0.9 或 0.8 的置信度值可能表示分类不可靠。
表格下方是 Text Recognized 区域。在此处,以紧凑形式显示已识别的完整文本。
正则表达式#
OCR 面临的一个典型挑战是字符 0、O 和 o 之间的歧义。OCR-A 或 SEMI 等显式 OCR 字体旨在区分 0 和 O,但其他字体则不然。您借助正则表达式可以解决这一挑战。
正则表达式允许您执行单词纠错。单词纠错是指不仅采用置信度最高的候选字符,还将其他候选字符纳入考量,以尝试找到符合正则表达式的候选字符组合。
为此,请在结果表格上方的输入框中输入与文本中单词数量一样多的正则表达式。用单空格分隔正则表达式。
Example: 假设您想要读取保质期,例如“03/2026”。主要目的是读取日期或时间的数字。同时假设也需要读取特殊字符或字母。在这种情况下,您将选择包含数字、字母和特殊字符的字符集。通过使用正则表达式 “(0[1-9]|10|11|12)/202[4-9]”,您能够在保持 MM/YYYY 日期结构的同时也读取斜杠。
信息
正则表达式无法通过添加或删除字符来纠正单词长度。正则表达式必须符合单词长度,并且所有图像的单词长度必须保持不变。
对长单词执行单词纠错可能会增加处理时间。
配置 vTool#
若要配置 OCR Basic vTool:
-
在 vTool Settings 区域的 Recipe Management 窗格中,点击 Open Settings 或双击该 vTool。
随即打开 OCR Basic 对话框。 -
拍摄或打开图像。
使用 Single Shot 按钮获取实时图像,或者点击 Open Image 按钮打开现有图像。
加载图像后,文本读取过程将立即开始,结果会显示在预览区域中。
窗口底部会显示识别出的字符,词与词之间用空格隔开。由于此处的空间有限,您可能无法看到全部文本。这仅用于指示已识别出多少个字符。完整文本将在向导的第 4 步中显示。
有关更多信息,请参阅 步骤 1:初始设置.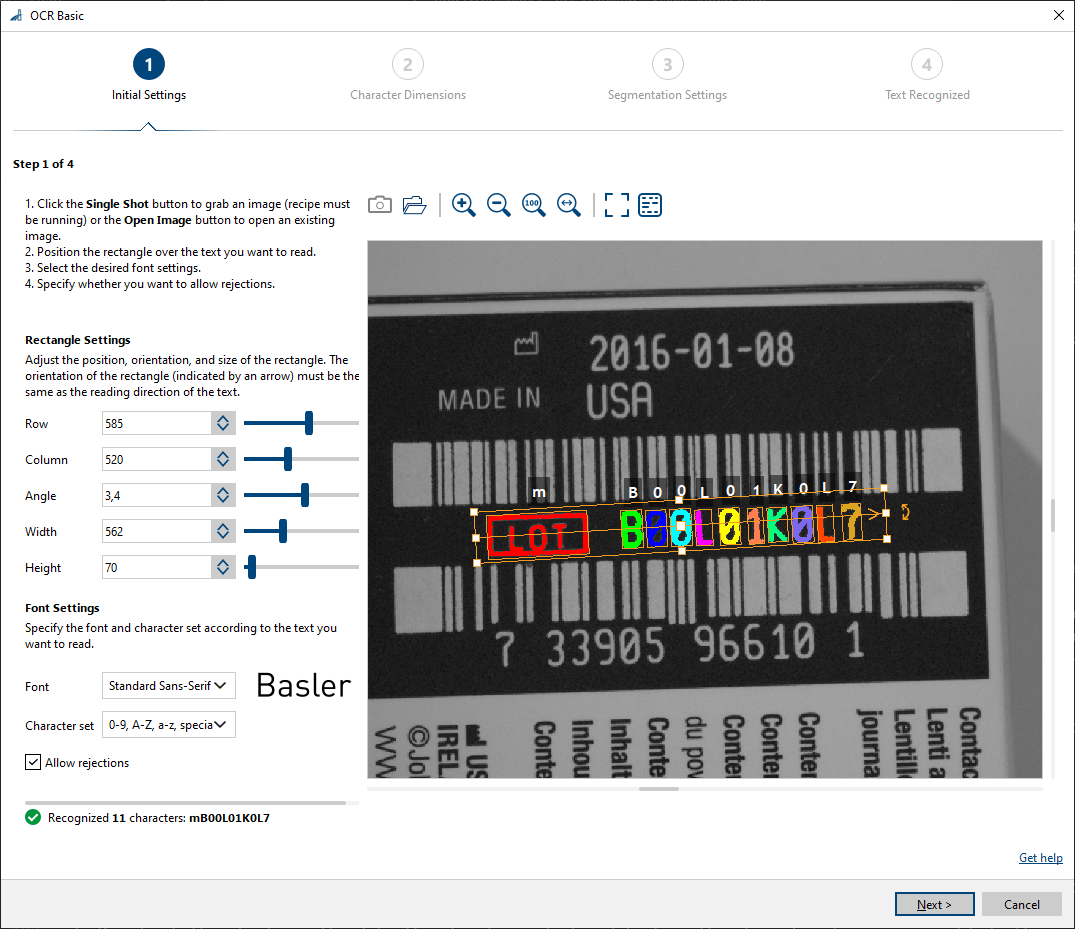
-
在 Rectangle Settings 区域中,通过手动输入数值来定义文本区域。
或者,您可以使用预览区域中区域矩形的控制柄来移动、调整大小和旋转它,使其贴合图像中您想要读取文本的部分。
矩形中的箭头必须指向文本的阅读方向。 -
在 Font Settings 区域中,配置以下选项:
- 字体类型
- 字符集
- 拒绝类别
-
单击 下一步.
步骤 2: OCR Basic 对话框即打开。
有关更多信息,请参阅 步骤 2:字符尺寸.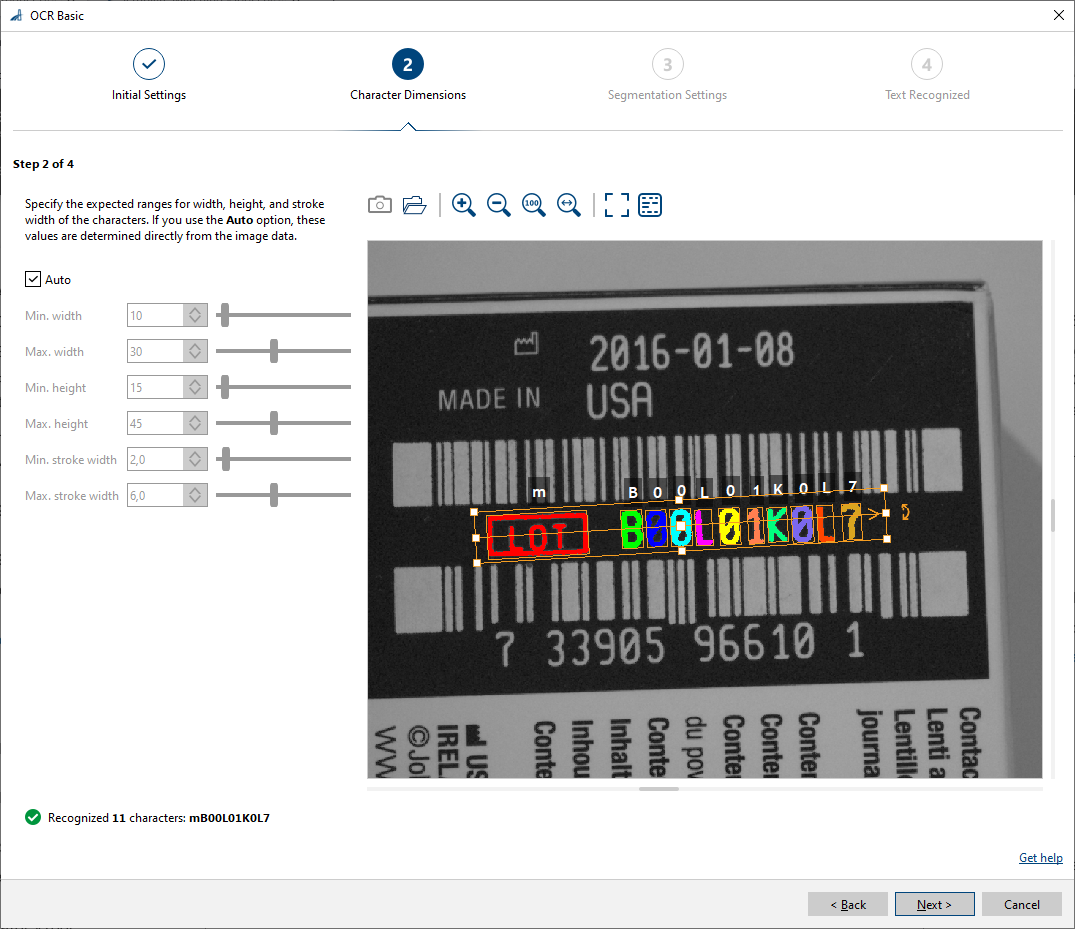
-
决定是否保持用于检测字符尺寸的默认自动模式处于启用状态。如果希望手动指定尺寸,请取消选中 Auto 选项,并输入所需的字符宽度、高度和笔画宽度范围。
-
单击 下一步.
Step 3 of the OCR Basic 对话框即打开。
有关更多信息,请参阅 步骤 3:分割设置.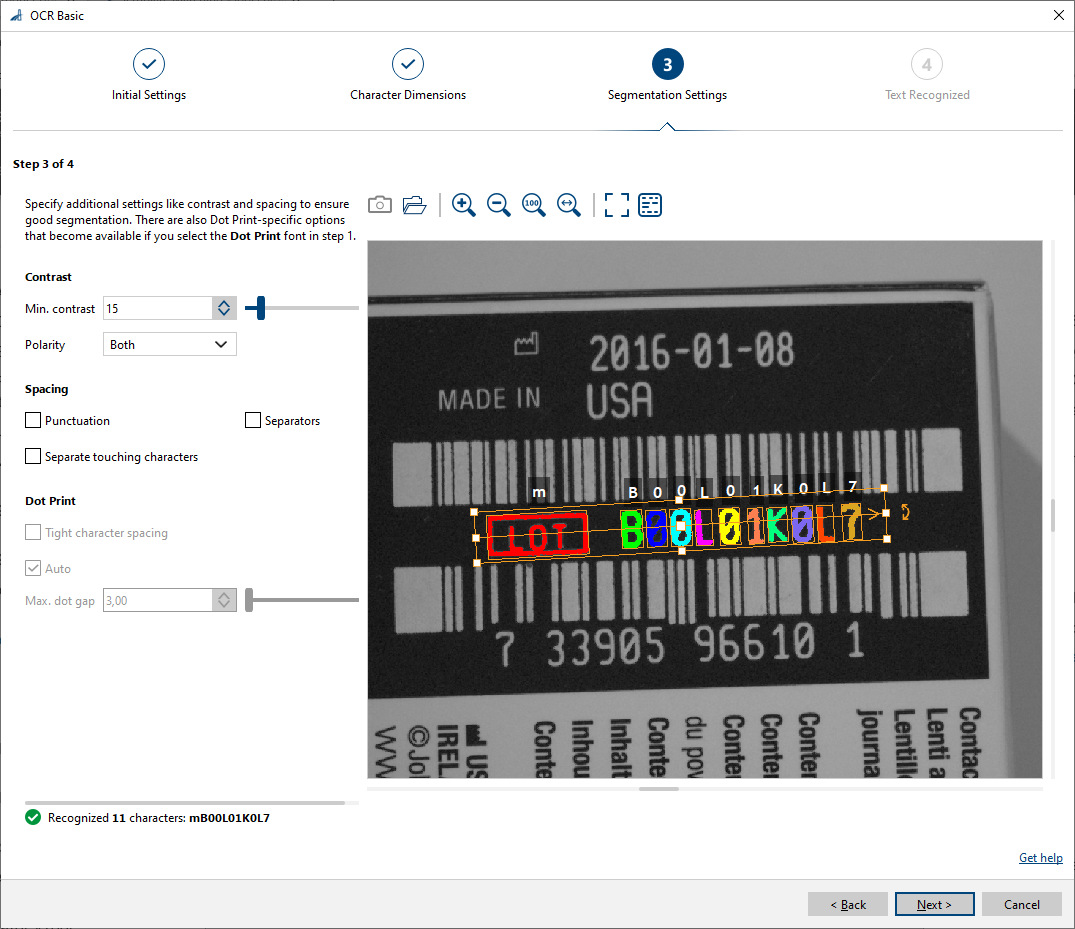
-
根据您的应用调整对比度和极性。
-
根据您的应用选择间距选项。
-
如果您选择了 Dot Print 字体,请根据需要指定选项。
-
单击 下一步.
Step 4 of the OCR Basic 对话框即打开。
有关更多信息,请参阅 步骤 4:结果.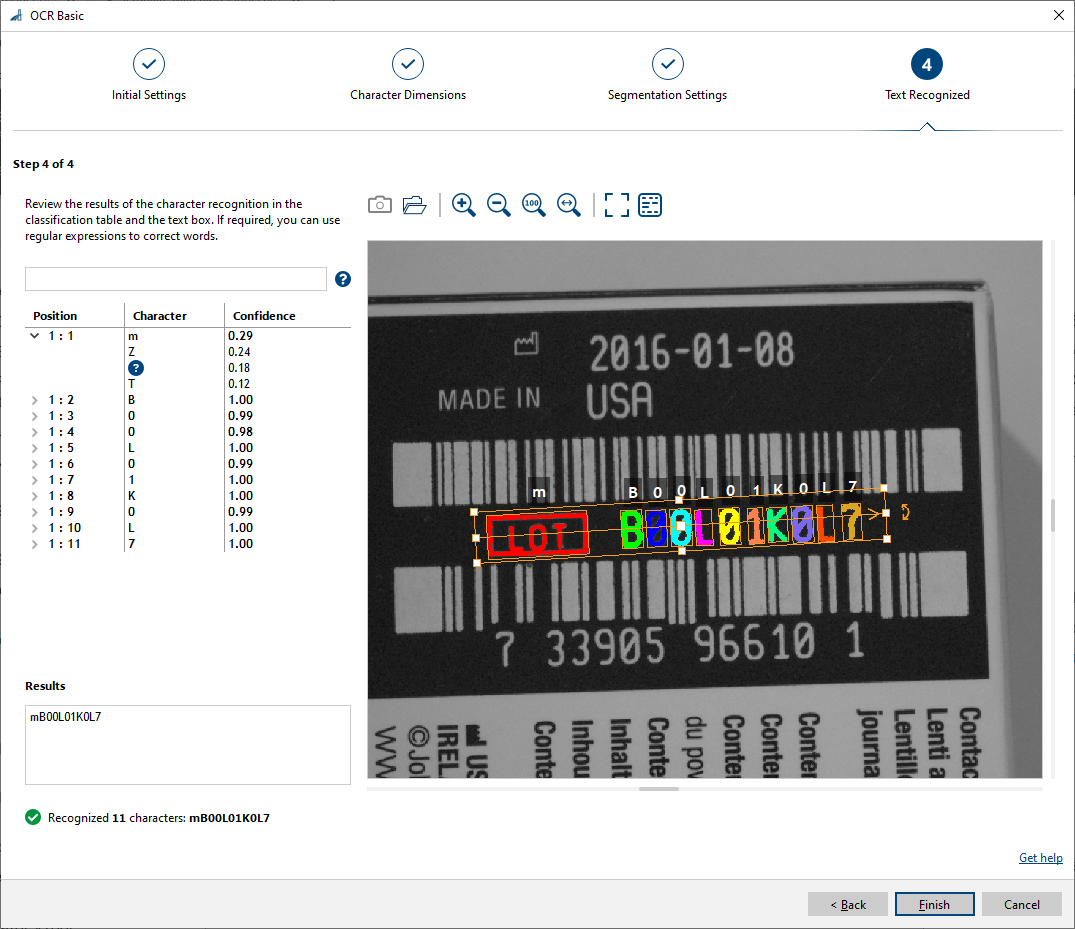
-
在分类表和文本字段中查看字符识别的结果。
在表中,您可以展开每个位置以打开备选分类结果。您可以看到分类后的字符及其置信度。
如果启用了详细视图选项,您可以在表中选择一个字符,预览区域中将高亮显示相应字符的边界框;反之,您也可以在预览区域中点击字符区域,以在表中查看相应的字符。 -
如果需要,输入 regular expressions 以执行单词校正。
每个单词输入一个正则表达式。表达式之间用单个空格隔开。 -
在 Text Recognized 字段中检查生成的单词。
-
点击 Finish 完成设置过程。
您可以在 pin data view 中查看 OCR Basic vTool 的结果。在这里,您可以选择要显示的输出。
输入#
图像#
直接从 Camera vTool 或从输出图像的 vTool(例如 Image Format Converter vTool)接受图像。
- 数据类型:图像
- 图像格式:8 位到 16 位单色或彩色图像。彩色图像在内部转换为单色图像。
输出#
文本#
返回识别出的文本字符串。
- 数据类型:字符串数组
区域#
返回识别出的文本区域。
- 数据类型:区域数组