pylon AI Agent#
DL 模型以捆绑包的形式与硬件配置等打包在一起,并通过 pylon AI Platform 发布。发布后,您可以使用 pylon AI Agent 在 Triton Inference Server 上为 pylon AI vTools 部署模型。
Triton Inference Server 负责处理推理过程。在深度 learning(深度学习)的语境下,推理是指将训练好的模型应用于新的、未见过的数据,并对内容进行预测。
pylon AI Agent 概述#
启动 AI Agent 有两种方法:
- 从 pylon Viewer 的 Workbench 菜单中
- 从 vTool 的设置对话框中
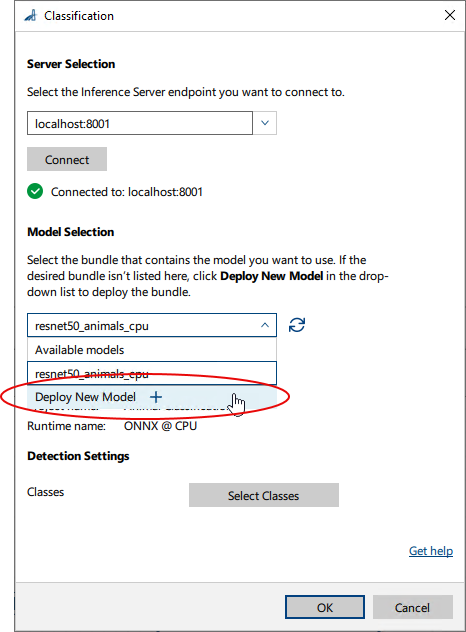
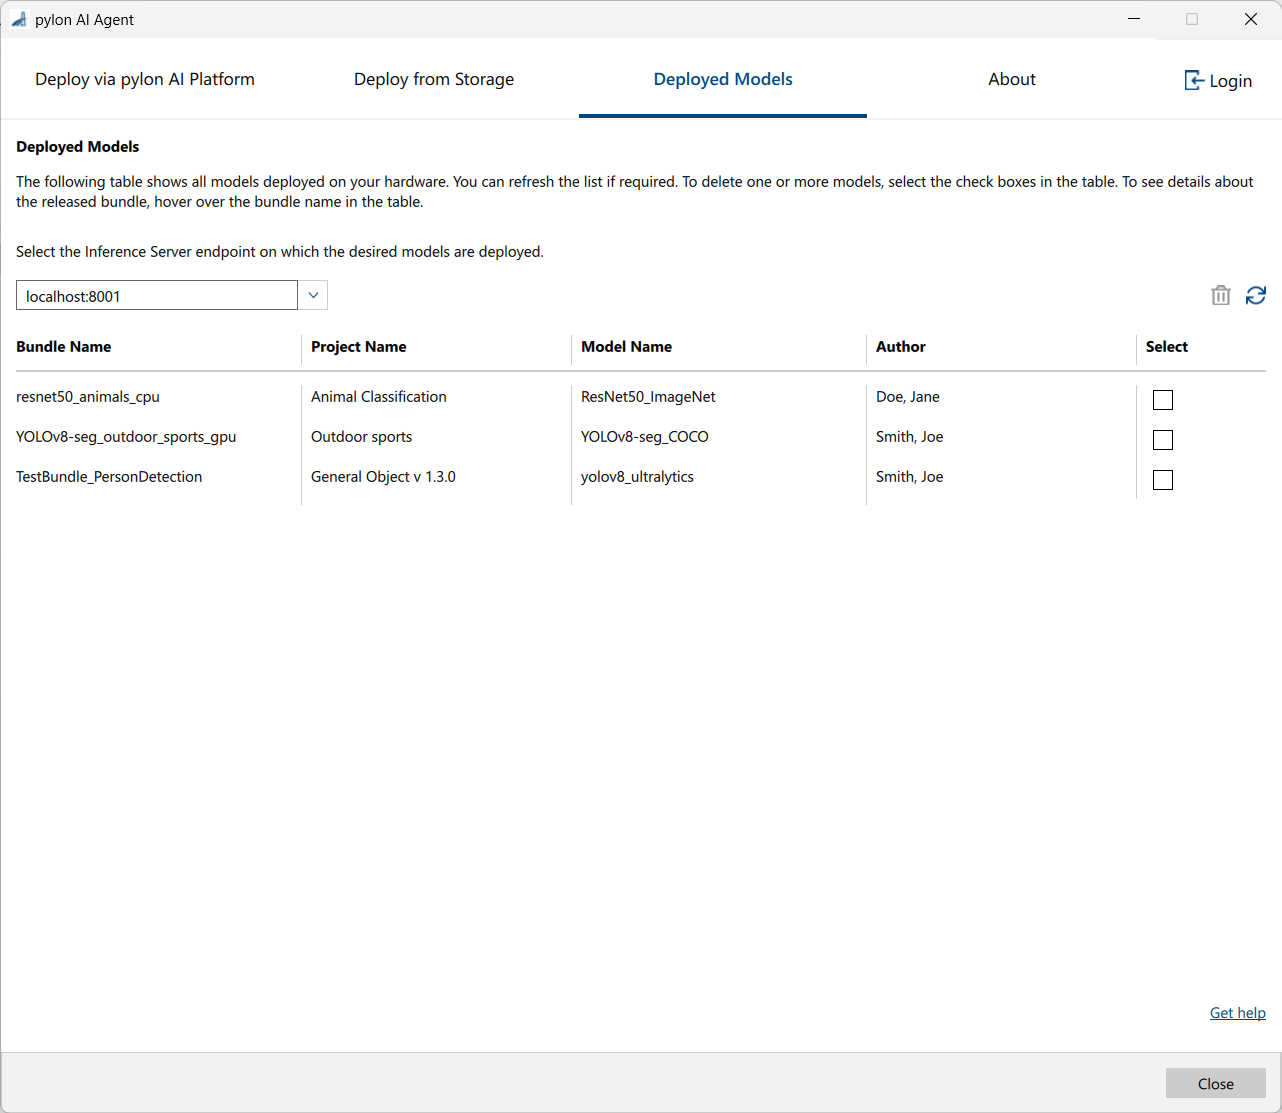
这两种方法都会在 Deployed Models 选项卡上打开 AI Agent。在此,您可以检查哪些模型已经部署。
要部署模型,您可以选择通过 pylon AI Platform 进行部署,或者从存储(例如您的硬盘驱动器或闪存驱动器)进行部署。
通过 pylon AI Platform 进行部署#
如果要通过 pylon AI Platform 部署模型,您必须注意以下几点:
-
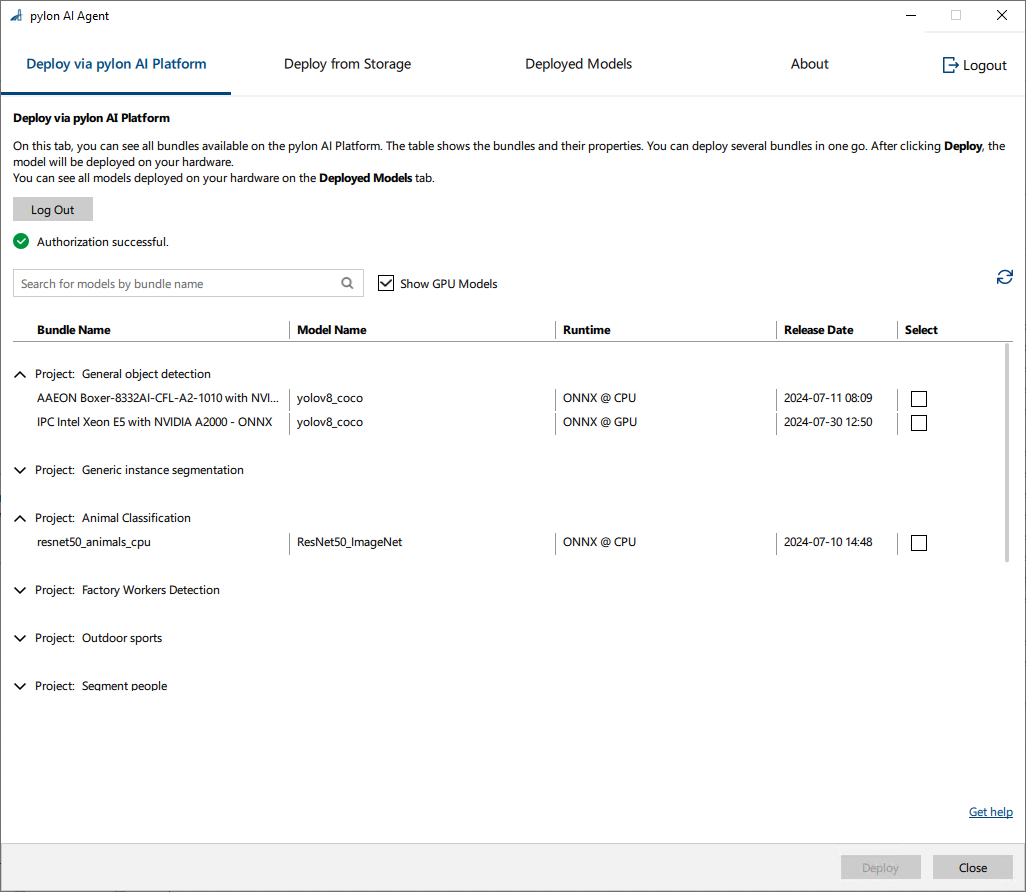
如果您从 Workbench 菜单中打开了 AI Agent,您将看到 通过 pylon AI Platform 部署 选项卡上所有视觉任务的所有可用模型。
-
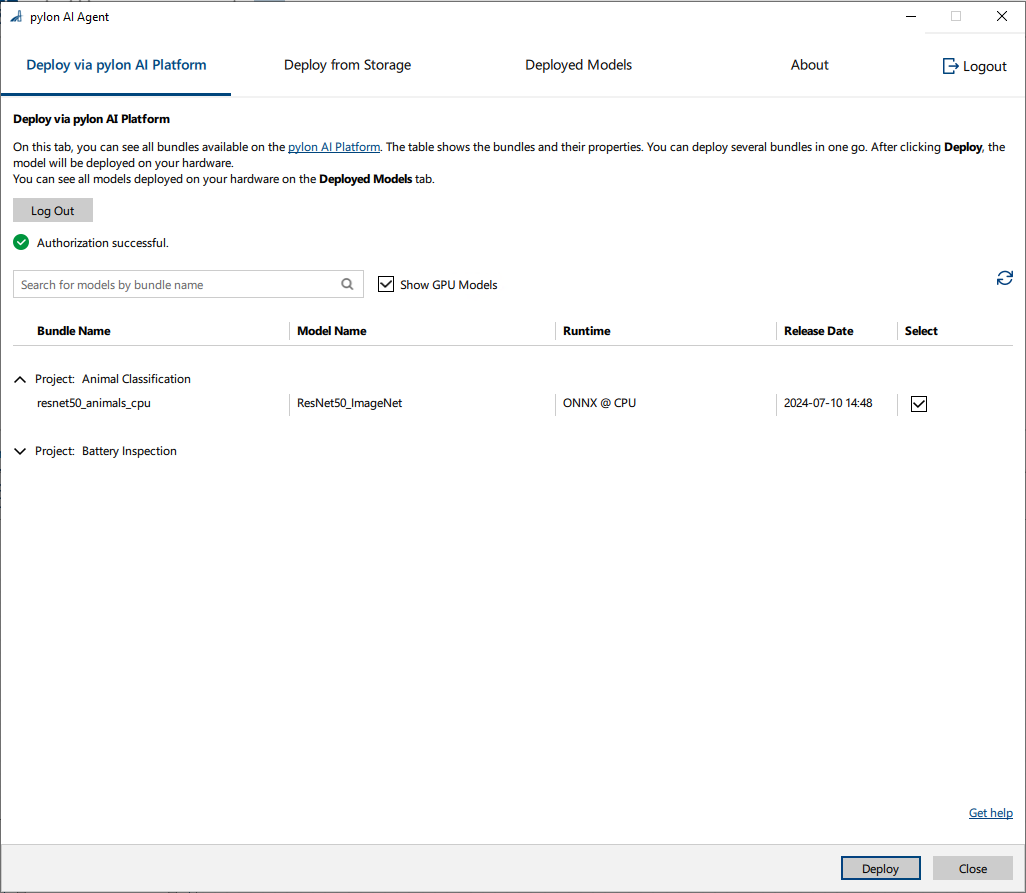
如果您从 vTool 的设置对话框中打开了 AI Agent,您将只能看到适合当前正在配置的 vTool 的模型。在以下截图中,AI Agent 是从 Classification vTool 的设置对话框中打开的。
从存储进行部署#
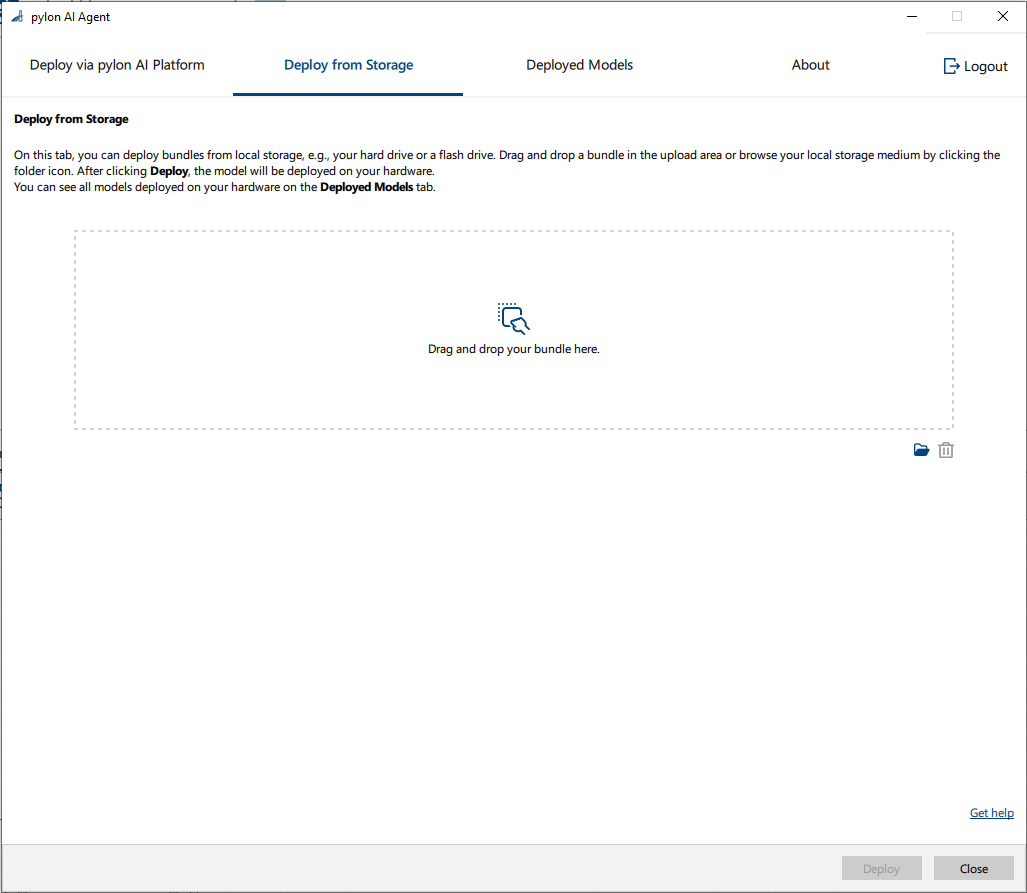
如果您想从存储中部署模型,则必须先将包含所需模型的捆绑包从 AI Platform 下载到所需的存储介质上。
部署模型#
- 启动 Triton Inference Server。
有关说明,请参阅 pylon AI 的 pylon Supplementary Package 中包含的安装文档。 - 通过以下方法之一启动 pylon AI Agent:
- 从 pylon Viewer 的 Workbench 菜单中
- 从 vTool 的设置对话框
pylon AI Agent 会在 Deployed Models 标签页中打开。在这里,您可以检查已经部署了哪些模型。
-
决定是从存储中部署新模型,还是通过 pylon AI Platform 进行部署。
-
从存储中部署
- 如果您尚未下载所需的 bundle,请从 pylon AI Platform 下载。
- 转到 Deploy from Storage 选项卡。
- 将 bundle 拖放到放置区域,或单击文件夹图标以浏览并选择所需的 bundle 文件。
这可以是本地或远程存储位置。 - 单击 Deploy。
- 在 选择服务器 对话框中,选择要部署模型的 Triton Inference Server。
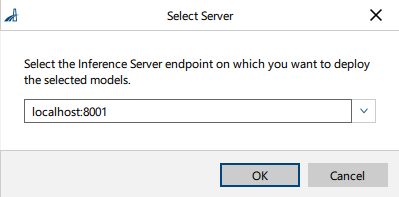
- 单击 OK。
部署将立即开始。部署完成后会显示一条消息。
-
通过 pylon AI Platform 部署
- 转到 Deploy via pylon AI Platform 选项卡。
- 单击 Log in 按钮登录 pylon AI Platform。
系统将转至 AI Platform 供您登录。登录后,网页应自动关闭并返回 AI Agent。如果没有发生这种情况,请手动返回 AI Agent 继续操作。 - 选择表中列出的一個或多个 bundle。
- 单击 Deploy。
- 在 选择服务器 对话框中,选择要部署模型的 Triton Inference Server。
- 单击 OK。
部署将立即开始。部署完成后会显示一条消息。
-
一般注意事项#
- Model naming: 您不能在 Triton Inference Server 上部署多个同名模型。每个模型在 Triton Inference Server 的模型存储库中必须具有唯一的名称。之所以需要唯一的名称,是因为 Triton Inference Server 将模型名称用作标识符来管理推理请求并将其路由到相应的模型。如果存在两个同名的模型,服务器将无法区分它们。
- Network latency and bandwidth: 确保可用带宽充足。下载大型模型可能会花费很长时间,特别是在带宽有限的网络上。
- Sufficient local storage: Triton Inference Server 需要足够的本地存储来缓存或临时存储下载的模型。如果本地存储有限,在同时部署大型或多个模型时可能会遇到问题。
- 远程运行服务器和 vTools: 如果您在远程计算机上运行 Triton Inference Server,并且还从其他位置运行 AI vTools,请注意以下重要限制和注意事项:
- 发起推理请求的 vTools 与 Triton Inference Server 之间传输数据所需的时间会影响整体响应时间。
- 高延迟可能会减慢推理过程,尤其是对于实时应用。
- 有限的网络带宽会导致通信缓慢或不可靠,特别是在传输大量数据时。