pylon AI Platform#
它为每个 AI vTool 提供不同的机器视觉项目,并允许您创建自己的项目。它支持模型生命周期管理的所有阶段(从开发到部署),包括针对各种硬件环境的模型优化。
请联系 Basler 销售人员以访问 pylon AI Platform。
运作原理#
作为介绍,以下各节提供了一些背景信息,并解释了使用 pylon AI Platform 创建项目的关键方面。
概念与术语#
Models:模型是可以使用样本图像进行训练的算法。基于训练,模型便能够“预测”图像内容。
Architecture:模型的架构决定了模型的工作方式。不同的机器视觉任务可使用不同的架构。
Data sets:数据集是与特定问题或任务相关的数据集合。它包含与该问题相关的所有视觉 Property。
例如,猫和狗的图像可以构成一个分类模型的数据集,用于区分猫和狗。如果模型不仅需要区分猫和狗,还需要区分老鼠,则必须将老鼠图像数据添加到数据集中。
通常,数据集分为三个部分:
- Training data:训练数据构成了深度学习模型用于学习的数据集的最大部分。模型会调整其权重,以识别训练数据中的模式。
- Validation data:验证数据由 DL 模型用于评估其在训练期间的行为。它独立于训练数据,不用于优化。
- Test data:训练完成后,使用测试数据评估模型的性能。测试数据代表新的、未见过的示例,并展示了模型对真实世界数据的泛化能力。
您可以使用 pylon Viewer 的 Recording feature 创建自己的数据集。要完成数据集,您还必须对图像进行标注。有关更多信息,请参阅下面的 Annotations/Labels 一节。完成数据集后,您可以将其添加到 pylon AI Platform 上的项目中。
目前,数据集仅支持 1.1 版本的 CVAT for images 格式。您可以使用 CVAT Server 标注数据,或者将现有数据集转换为 CVAT for images 1.1 格式。
对于后者,您可以将数据集从训练环境导出为 CVAT 格式,或者使用第三方工具转换现有数据集。为此,Basler 建议使用 Datumaro。
Annotations/Labels:Annotations(也称为标签)被添加到数据集中,用于向模型告知数据中的重要内容。在训练过程中,模型利用此信息将预测结果与期望/正确的结果进行比较。对于上述分类任务,此信息指示图像描绘的是狗还是猫。
若要为 pylon AI 的使用标注图像,您可以使用外部训练平台或开源工具CVAT。此视频演示了如何使用 CVAT 为 Object Detection 对图像进行边界框标注。
Training:在深度学习的语境下,Training 是指神经网络(模型)从训练数据中学习的过程。模型针对所有训练数据做出预测(参见上文的“Data sets”)。将预测结果与真实情况数据(Annotation/Label)进行比较,以计算偏差。根据偏差调整模型的权重,以将偏差最小化。此过程会不断重复,直到误差尽可能减小。为了验证模型的性能,该模型会被应用于验证数据。
Inference:在深度学习的语境下,Inference 是指将已训练的模型应用于新的、未见过的数据,并对内容做出预测。
使用 pylon AI Platform#
本节将引导您了解创建机器视觉项目的各个步骤。
pylon AI Platform 旨在实现直观易用的操作。登录 pylon AI Platform 后,您将看到 Dashboard 视图。

这里显示了最近发布的 5 个 bundle 以及最近运行的 5 个试验。
要开始创建项目,请点击左侧导航树中的 My Projects。

在 My Projects 视图中,您可以看到您本人或有权访问 AI Platform 的其他人员所创建的所有项目。您可以选择以列表视图或平铺视图显示项目。
项目创建#
您首先需要创建一个项目。
- 登录 pylon AI Platform。
- 点击左侧导航树中的 My Projects。
- 在 My Projects 页面上,点击 Create new project。
- 在 创建新项目 页面上,指定要创建的项目类型,并输入名称和简短描述(可选)。
将打开一个项目概览页面。
顶部的选项卡导航显示了您当前可以执行的所有步骤。某些步骤只有在完成前置步骤后才会可用。
在 notification area 中,您在 AI Platform 上执行的每个操作都会弹出一个新消息。所有消息都会保存,直到您选择将其删除。
主页按钮可带您返回项目的概览页面。
数据集#
-
点击 Add data set 按钮或点击上方选项卡列表中的 Data Sets。
-
在 添加数据集 页面上,为要添加的数据集输入名称和简短描述(可选)。

-
点击 Add。
-
在 Upload Data 页面上,指定要上传的数据格式并添加数据。
目前,数据集仅支持 1.1 版本的 CVAT for images 格式。您可以使用 CVAT Server 标注数据,或者将现有数据集转换为 CVAT for images 1.1 格式。
对于后者,您可以将数据集从训练环境导出为 CVAT 格式,或者使用第三方工具转换现有数据集。为此,Basler 建议使用 Datumaro。
数据验证随即开始。验证成功完成后,您可以检查标注并继续创建数据集类别。

-
点击 Map classes。
-
在 类别映射 对话框中,点击 自动创建类别 以根据图像中的标注自动创建数据集类别。
或者,点击 添加新类别 在下方的下拉列表中 数据集类别.
-
单击确定。
-
在 Upload Data 页面上,点击 Upload。
随即打开 Data Sets 标签页,您可以在其中查看您的数据集。 -
点击该数据集以查看其内容、添加图像并编辑其 Property。如果您对数据集的状态满意,请点击 发布.
您必须发布数据集才能在试验中使用它。
-
返回到 Data Sets 标签页。
型号#
-
点击 Models 标签页。
-
在 Models 页面上,点击 Add model。
-
在 上传模型 页面上,输入您要添加的模型的名称和简短描述(可选)。

-
点击 Create。
-
在 上传模型 页面上,指定要上传的模型的配置并添加模型文件。
上传和验证将立即开始。完成后,您可以检查您的模型包含哪些类别。
-
点击 Finish。
将打开 Models 标签页,您可以在其中查看您的模型。 -
点击模型以查看其属性。

-
返回到 Models 标签页。
映射#
数据集和模型通常包含比特定任务所需更多的类别。映射是将数据集类别与模型类别相匹配的过程,用于定义项目所寻找的内容。为此,您必须添加项目类别并为其分配所需的数据集和模型类别。
-
单击工具栏中的 映射 选项卡上所有视觉任务的所有可用模型。

-
在 映射 标签页,点击 创建项目类别 以创建您的第一个项目类别。

或者,您可以使用 自动映射 功能。
-
如果需要,将默认名称更改为其他名称。
-
向其中添加数据集类别和模型类别。
您可以直接从右侧相应的标签页中拖放类别。使用下拉列表,您可以更改数据集或其版本以及模型版本。
-
重复步骤 2 到 4,直到创建了所需的所有项目类别。
-
排除所有不需要的数据集和模型类别(有关详细信息,请参阅 排除类别)。
自动映射#
自动映射允许您一键根据名称将数据集和模型类别映射到项目类别。如果没有与数据集和模型类别名称相匹配的项目类别,系统将创建一个具有该名称的新项目类别。因此,如果您拥有比实际使用更多的数据集或模型类别,请确保在使用自动映射之前将其排除。
自动映射仅适用于未映射的类别。先前手动映射的任何类别将保留在其各自的类别中。
如果数据集或项目类别的名称包含单词“background”或“excluded”,则会根据项目类型将其排除或定义为背景。
自动映射不区分大小写,但类别的名称必须完全一致。
要使用自动映射:
-
在右侧的 Data Set Classes 选项卡上,排除所有不需要的数据集类别。
-
单击 自动映射.

-
在 Automapping Summary 对话框中,检查您是否要创建其中列出的所有项目类别。
您可以取消选择任何不需要的类别。取消选择的类别将保持未映射状态。请确保随后将它们排除。 -
点击 Map classes。
将创建项目类别,并将数据集类别添加其中。 -
在右侧的 Model Classes 选项卡上,排除所有不需要的模型类别。
-
单击 自动映射.

-
Automapping Summary 对话框显示现有的项目类别、将映射到这些类别的模型类别以及将要创建的任何新项目类别。检查您是否要创建列为新建的项目类别。
您可以取消选择任何不需要的类别。取消选择的类别将保持未映射状态。请确保随后将它们排除。 -
点击 Map classes。
系统将创建尚不存在的项目类别。模型类别将被添加到新的和现有的项目类别中。
排除类别#
若要完成映射,必须排除不想在项目中使用的模型类别。这对于从模型中获取正确的统计数据是必要的。
要排除类别,请选择所有不需要的模型类别,然后点击 Exclude。或者,您可以将所选类别拖动到屏幕底部并将其放到 Excluded 区域中。

对于分割项目,情况略有不同。在这里,所有多余的模型类别必须定义为背景。为此,请选择所有不需要的模型类别,然后点击 Define as background。或者,您可以将所选类别拖动到屏幕底部并将其放到 Background 区域中。
这两种操作都可以通过使用相应的按钮或通过拖放来撤销。
应用项目时,将不考虑排除的类别。这意味着您将不会获得有关它们的任何结果。
试验#
-
点击 Trials 选项卡。
-
在 Trials 页面上,点击 Add trial。
-
在 创建试验 页面中,输入要添加的试验的名称和简短描述(可选)。

-
在 项目资产 区域)中,单击 添加数据集 以选择要用于试验的数据集。

-
在 项目资产 区域)中,单击 添加模型 以选择要在试验中使用的模型。

-
在 项目资产 区域)中,单击 检查映射.
您应检查映射并进行任何必要的更改。创建试验后,将无法再更改项目类别。
-
点击 Create。
-
单击 Add next trial run。
-
选择硬件和模型格式。

-
单击 运行试验.

试验运行随即开始。运行结束后,统计数据将显示在试验页面上。
-
如果您对结果满意,可以通过单击试验旁边的 Release bundle 按钮来发布 bundle。

-
更改 bundle 的名称并输入描述(可选)。

-
单击 Release bundle。
正在生成 bundle。 -
返回项目概述页面并单击 Bundles 选项卡。
稍等片刻后,您的 bundle 将显示在此处。
软件包#
发布后,bundle 将显示在 Bundles 选项卡上。在此处,您可以检查 bundle 的 Property,并查看生成该 bundle 的试验运行的详细信息。

bundle 包含 vTool 执行其机器视觉任务所需的所有必要信息,例如硬件配置、模型等。现在,它已准备好使用 pylon AI Agent 部署到 AI vTools。
您还可以将 bundle 下载到本地或远程存储位置。在这种情况下,无法访问 pylon AI Platform 的用户仍然可以使用 bundle 中的模型。
外部项目#
pylon AI Platform 允许您连接到其他平台,例如 Intel Geti 和 Landing AI。您可以导入在这些平台上创建的项目,并在其上运行使用不同硬件和模型的试验。
要建立与另一个平台的连接,您必须添加该平台的 API 密钥。
若要添加 API key:
- 登录 pylon AI Platform。
- 在左侧导航树中,点击 设置.
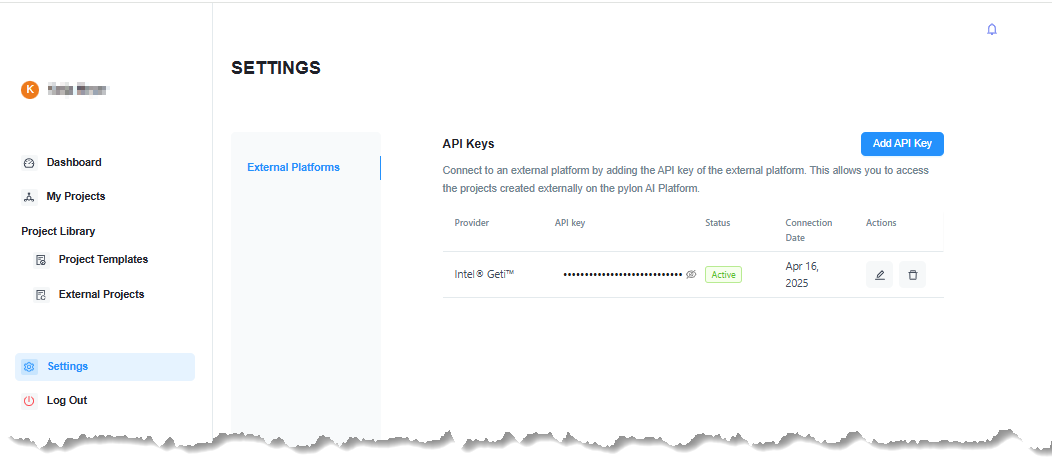
- 在 设置 视图,点击 Add API Key.
即: Add API Key 对话框即打开。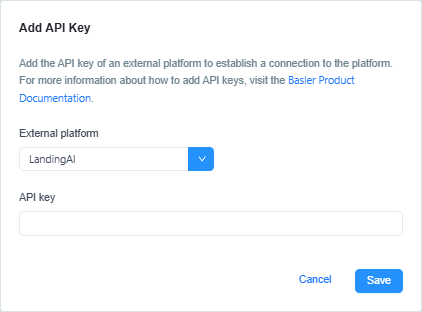
- 在 Add API Key 对话框中,选择所需的平台并输入该平台的 API key。
有关获取 API key 的说明,请参见此处:
Intel Geti
Landing AI - 点击 Save。
您添加的 API key 将显示在 API Keys 页面上。此外,您已建立连接的外部平台上创建的项目现在也可在 External Projects 视图中使用。
现在,您可以将外部项目导入您的项目库中并进行测试。请注意,外部项目是只读的。您无法在 pylon AI Platform 上编辑其资源(例如数据集)。如果您想进行更改,必须在原平台上进行。
若要导入外部项目:
- 在左侧导航树中,点击 外部项目.
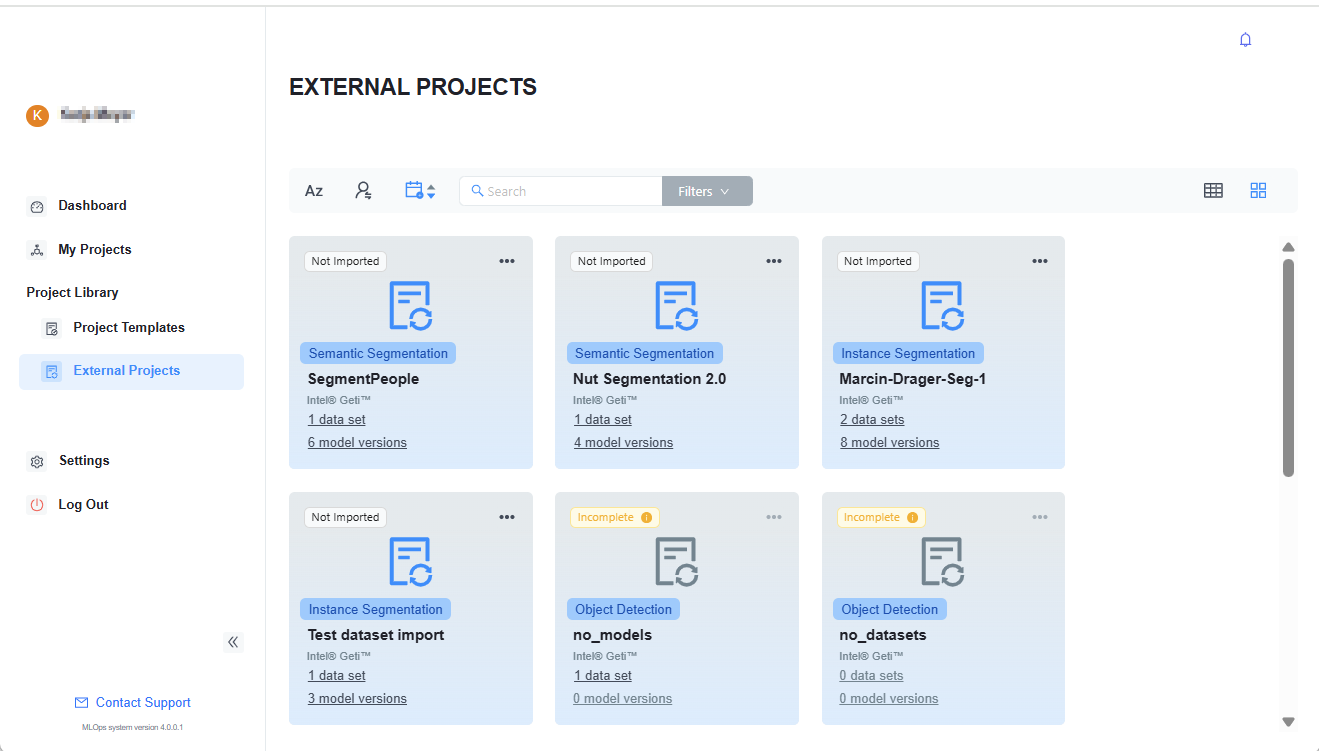
- 点击您想要导入的项目。
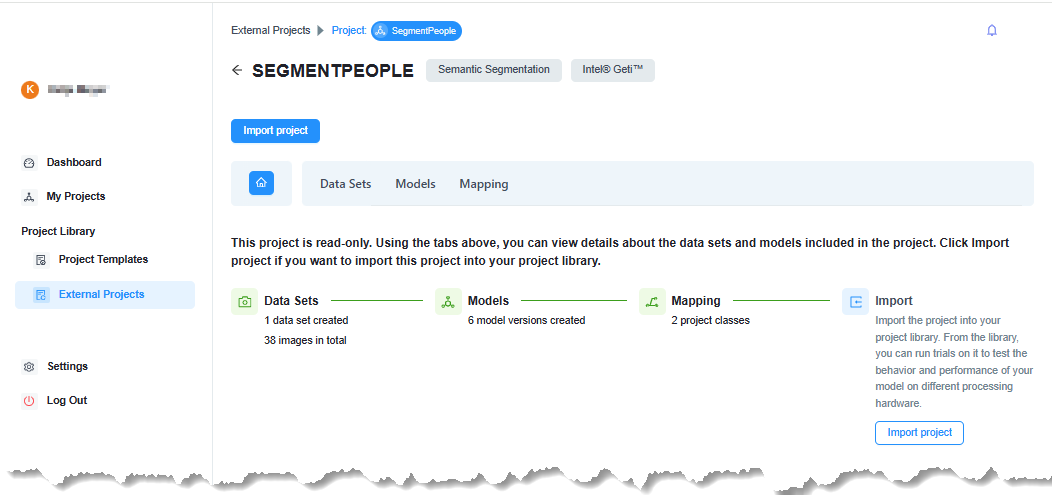
- 在 Data Sets、Models 和 Mapping 选项卡上查看项目的资源。
- 如果您对项目满意,请点击 Import project.
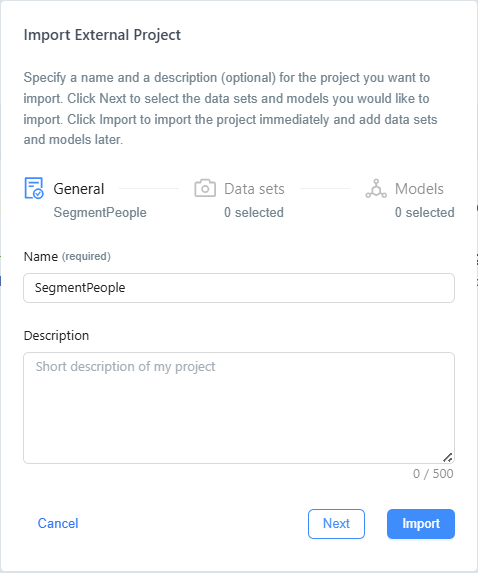
- 输入名称和简短描述(可选)。
- 单击下一步。
- 选择您想要导入的数据集。
您也可以在后续阶段执行此操作。您只能导入属于该外部项目一部分的数据集。 - 单击下一步。
- 选择您想要导入的模型。
您也可以在后续阶段执行此操作。您只能导入属于该外部项目一部分的模型。 - 点击 Import。
该项目将被导入并添加至您的项目库中。 - 在左侧导航树中,点击 My Projects.
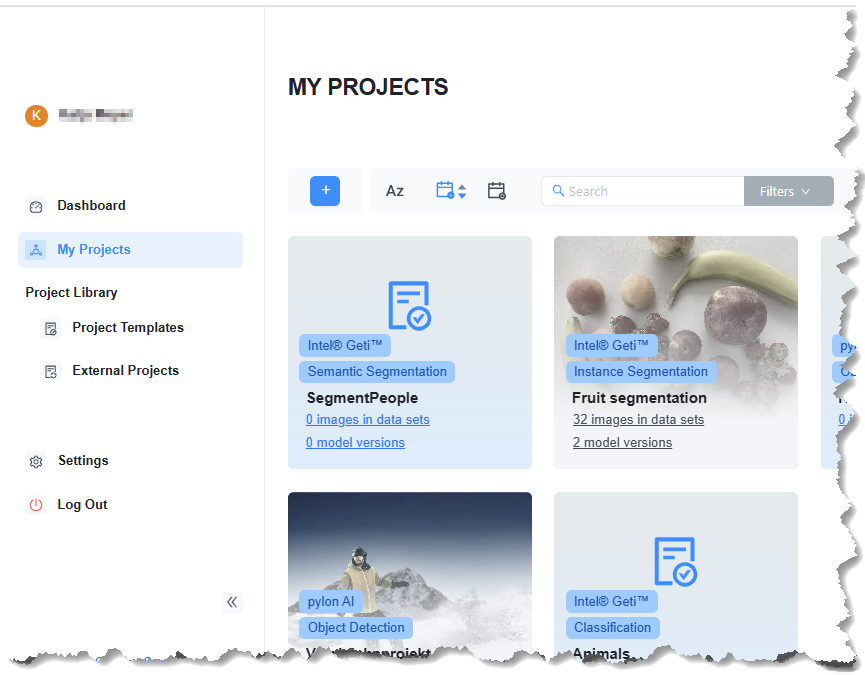
您刚刚添加的项目现已可用。 - 点击该项目进行编辑(例如添加数据集和模型,如果您尚未添加的话)并查看映射。
- 运行 trials 并创建 bundles。